Git на сервере: базовые команды и деплой через git pull
Разбираем команды Git, которые реально нужны при работе с сервером, простую схему деплоя через git pull, права доступа после обновления файлов и что делать, если в репозиторий попал секрет.
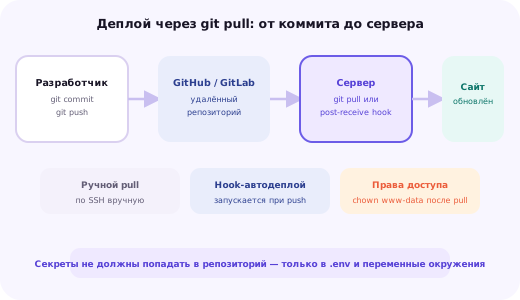
Git на сервере: не тот же набор задач, что при разработке
Работа с Git на production-сервере отличается от повседневной работы разработчика в IDE — здесь редко создают ветки, почти никогда не делают коммиты и не разрешают сложные конфликты слияния. Типичный набор операций на сервере узкий: получить актуальную версию кода, посмотреть, что изменилось, и, если что-то пошло не так, откатиться к рабочей версии.
Эта статья не претендует на полный курс по Git — она разбирает именно тот минимальный, но абсолютно необходимый набор команд, который реально используется при управлении сервером, простейшую схему деплоя через git pull, типичные проблемы с правами доступа после обновления файлов и отдельно — серьёзный вопрос о секретах, случайно попавших в репозиторий.
Если процесс деплоя на вашем проекте уже перерос простой git pull и требует автоматического тестирования перед выкладкой — соответствующий следующий шаг разобран отдельно в статье про CI/CD с GitHub Actions.
Базовые команды: то, что реально используется на сервере
git clone разворачивает копию удалённого репозитория в новую директорию — эта команда выполняется на сервере обычно один раз, при первом развёртывании проекта.
git clone git@github.com:acme/site.git /var/www/example.rugit status показывает текущее состояние рабочей директории — какие файлы изменены, добавлены или не отслеживаются Git; на сервере эта команда — первое, что стоит выполнить перед любым git pull, чтобы убедиться, что в рабочей копии нет случайных незакоммиченных правок, которые могли бы конфликтовать с обновлением.
git status
git log --oneline -10
git diff HEAD~1
git log --oneline даёт компактный список последних коммитов с их короткими хешами — полезно, когда нужно точно понять, какая версия кода сейчас развёрнута на сервере, особенно если несколько человек имеют доступ к деплою и нужно быстро восстановить хронологию изменений.
git checkout a1b2c3dgit checkout по хешу коммита переводит рабочую директорию в состояние на момент этого коммита — удобно для быстрого аварийного отката на сервере, если только что задеплоенная версия оказалась нерабочей, хотя для регулярного использования правильнее откатывать сам код в репозитории (через revert) и потом уже деплоить исправленную версию, а не оставлять сервер в отсоединённом (detached HEAD) состоянии надолго.
.gitignore: что не должно попадать в репозиторий
Не каждый файл проекта должен отслеживаться Git — сгенерированные зависимости, временные файлы и, что особенно важно, файлы с секретами конфигурации не место в истории репозитория. Список исключений задаётся файлом .gitignore в корне проекта.
# PHP-проект
/vendor/
.env
*.log
/storage/cache/

# Node.js-проект
/node_modules/
.env
npm-debug.log*
/dist/
Директория vendor (для PHP) или node_modules (для Node.js) полностью восстанавливается из composer.lock или package-lock.json соответствующей командой установки зависимостей — хранить её в Git избыточно и раздувает репозиторий без какой-либо пользы для воспроизводимости.
Файл .env, содержащий пароли от базы данных, ключи внешних API и другие секреты конкретного окружения, — самый важный пункт этого списка: в отличие от кода, значения в .env различаются между разработкой, staging и production, и попадание production-секретов в общий репозиторий, доступный, например, всей команде разработки, превращает утечку доступа во внутренний, а не только внешний риск.
Важная деталь: .gitignore действует только на файлы, которые Git ещё не отслеживает. Если .env был закоммичен раньше, а правило в .gitignore добавлено уже потом, файл продолжит отслеживаться — его нужно явно убрать из индекса командой git rm --cached .env, и только после этого правило .gitignore начнёт применяться к нему в будущих коммитах.
Простейшая схема деплоя: git pull на сервере
Для небольшого проекта без сложного CI/CD-пайплайна вполне рабочая схема деплоя — зайти на сервер по SSH и выполнить git pull в директории проекта, после чего перезапустить нужные сервисы (PHP-FPM, менеджер процессов Node.js).
cd /var/www/example.ru
git pull origin main
composer install --no-dev --optimize-autoloader
systemctl restart php8.3-fpm
Эту последовательность легко оформить одним shell-скриптом, чтобы не выполнять команды по одной вручную каждый раз, а вызывать единой командой deploy.sh — это снижает риск человеческой ошибки вроде забытого шага установки зависимостей после обновления кода.
#!/bin/bash
set -e
cd /var/www/example.ru
git pull origin main
composer install --no-dev --optimize-autoloader
chown -R www-data:www-data /var/www/example.ru
systemctl restart php8.3-fpm
echo "Деплой завершён: $(git rev-parse --short HEAD)"
Директива set -e в начале скрипта останавливает выполнение при первой же ошибке любой из команд — без неё, например, неудачный git pull из-за проблем сети не остановит скрипт, и composer install продолжит выполняться уже поверх старого кода, создавая ложное впечатление успешного деплоя.
Такой скрипт можно запускать вручную по SSH, привязать к cron-задаче с определённым интервалом (менее удобно, так как деплой происходит не в момент реального обновления кода, а по расписанию) или вызывать через веб-хук — небольшой обработчик на сервере, который GitHub или GitLab дёргает автоматически при пуше в нужную ветку, инициируя git pull сразу после появления новых коммитов без участия человека.
Права доступа после git pull: частая практическая проблема
git pull по умолчанию создаёт и изменяет файлы от имени того пользователя, под которым выполняется команда — обычно это личная учётная запись администратора, использующего SSH для подключения к серверу. Веб-сервер и PHP-FPM при этом чаще всего работают от отдельного системного пользователя (www-data, nginx или аналогичного), которому нужны права на чтение (а иногда и запись, например для директории загрузок) этих же файлов.
Если после git pull не привести владельца файлов в соответствие с пользователем веб-сервера, результат бывает разным в зависимости от конкретной настройки: от полностью рабочего сайта (если группа доступа настроена достаточно широко) до ошибок доступа к отдельным файлам или полной невозможности PHP-FPM прочитать обновлённый код.
chown -R www-data:www-data /var/www/example.ru
find /var/www/example.ru -type d -exec chmod 755 {} \;
find /var/www/example.ru -type f -exec chmod 644 {} \;
Правильная практика — не выполнять этот шаг вручную после каждого git pull (что легко забыть), а включить его как обязательный этап в сам скрипт деплоя, как показано в предыдущем разделе, так что права доступа автоматически приводятся в порядок при каждом обновлении кода без дополнительных действий со стороны того, кто запускает деплой.
Отдельная деталь: директории, куда приложение само пишет во время работы (загруженные пользователями файлы, кэш, логи), должны оставаться доступными на запись пользователю веб-сервера и после git pull — если такая директория случайно попадёт под общий chown с ограничивающими правами 644 для файлов внутри неё, приложение перестанет мочь писать новые файлы в неё, хотя сам код при этом обновится без видимых ошибок.
Когда git pull перестаёт быть достаточным решением
Прямой git pull на боевом сервере хорошо работает для небольших проектов с редкими обновлениями и невысокими требованиями к отказоустойчивости самого процесса деплоя. По мере роста проекта у этой схемы проявляются ограничения, о которых стоит знать заранее.
Во время выполнения git pull и последующей установки зависимостей сайт формально уже обновляется файл за файлом — на короткий момент часть кода уже новая, а часть ещё старая, что теоретически может привести к рассинхронизации, если, например, изменился формат данных между старым и новым кодом. Для большинства простых сайтов этот момент настолько короткий, что остаётся незамеченным, но для высоконагруженных сервисов это повод присмотреться к более надёжным схемам вроде симлинка на новую директорию с полностью готовым кодом, переключаемого одной атомарной операцией.
Ещё одно ограничение — отсутствие автоматической проверки, что обновляемый код вообще работает, перед тем как он окажется на продакшне: git pull применяет любые коммиты из указанной ветки без какой-либо проверки, был ли код протестирован. Решение этой проблемы — вынесение тестирования в отдельный автоматизированный этап перед деплоем, что подробно разобрано в статье про CI/CD с GitHub Actions.
Секреты в репозитории: почему это серьёзная ошибка
Коммит файла .env, файла с приватным ключом или любого другого файла с реальными паролями и токенами доступа — одна из самых распространённых и при этом самых опасных ошибок в работе с Git. Проблема не ограничивается тем, что файл виден в текущем состоянии репозитория.
Git не забывает — однажды закоммиченный файл остаётся доступным через историю репозитория даже после того, как его удалили последующим коммитом; единственный надёжный способ убрать секрет из истории — считать его скомпрометированным и заменить.
Общепринятая практика реагирования на утечку секретов через систему контроля версий
Даже если репозиторий приватный и доступен только внутренней команде, риск не исчезает: список людей с доступом к репозиторию меняется, доступ к клонированным копиям на локальных машинах разработчиков не всегда так же строго контролируется, как доступ к самому production-серверу, а при случайном или намеренном изменении видимости репозитория (например, при переносе в другую организацию на GitHub) исторические коммиты остаются доступны вместе со всем содержимым.
Простое удаление файла последующим коммитом (git rm .env && git commit) не решает проблему — файл продолжает существовать в истории и доступен любому, кто выполнит git log и посмотрит на более ранние коммиты или просто скачает файл конкретной ревизии командой git show.
Единственно правильная последовательность действий при обнаружении утечки: во-первых, немедленно считать все секреты в утёкшем файле скомпрометированными и сменить их — новые пароли к базе данных, перевыпущенные ключи API, новые токены доступа; во-вторых, уже после смены реальных значений, при желании почистить историю репозитория инструментами вроде git filter-repo, что решает проблему на будущее, но никак не отменяет факт, что старые (теперь уже недействительные) значения кто-то мог успеть увидеть.
Веб-хук как альтернатива ручному деплою
Промежуточный шаг между полностью ручным git pull по SSH и полноценным CI/CD-пайплайном — веб-хук, автоматически запускающий скрипт деплоя на сервере сразу после пуша в нужную ветку, без участия человека и без необходимости заходить на сервер вручную для каждого обновления.
Механизм простой: на сервере поднимается небольшой обработчик (отдельный лёгкий HTTP-сервис или обработчик внутри уже существующего веб-сервера), слушающий определённый путь; GitHub или GitLab при пуше в репозиторий отправляет на этот путь POST-запрос с информацией о коммите, и обработчик в ответ запускает уже знакомый скрипт deploy.sh.
Важная деталь безопасности такой схемы — проверка подписи входящего запроса (GitHub и GitLab подписывают тело запроса секретным ключом, заданным при настройке веб-хука), чтобы обработчик не запускал деплой по любому произвольному запросу на этот URL, а только по запросу, действительно пришедшему от настроенного репозитория.
Для проектов, где уже используется тестирование перед деплоем, установка зависимостей на отдельном шаге сборки или деплой сразу на несколько серверов, веб-хук на голом shell-скрипте быстро становится тесен — это естественная граница, за которой имеет смысл переходить на полноценный CI/CD-пайплайн, разобранный в отдельной статье.
Резервная копия перед обновлением: страховка на случай неудачного деплоя
Git сам по себе не заменяет резервное копирование — история коммитов защищает код проекта, но ничего не знает о содержимом базы данных, загруженных пользователями файлах или содержимом .env, которые обновление кода может затронуть косвенно, например через миграцию структуры базы данных, идущую вместе с новым релизом.
Перед деплоем, вносящим изменения в структуру базы данных, разумная практика — сделать её резервную копию отдельно от самого шага git pull, чтобы в случае неудачной миграции откат состоял не только из возврата к предыдущему коммиту кода, но и из восстановления базы данных к согласованному с этим кодом состоянию.
mysqldump -u backup_user -p myapp | gzip > /backups/pre-deploy_$(date +\%Y\%m\%d_\%H\%M).sql.gz
git pull origin main
Полноценная стратегия резервного копирования (регулярные автоматические копии, хранение вне самого сервера, проверка восстановления) выходит за рамки одного лишь процесса деплоя и разобрана отдельно — но даже простой ручной дамп базы данных перед деплоем, вносящим изменения в её структуру, снимает значительную часть риска, связанного с миграциями схемы.
Чек-лист безопасного git-деплоя
Шаг 1. Настройте .gitignore для vendor/node_modules, .env и любых временных или сгенерированных файлов ещё до первого коммита проекта.
Шаг 2. Разворачивайте проект на сервере через git clone по SSH-ключу, а не по логину и паролю к репозиторию.
Шаг 3. Оформите последовательность git pull, установки зависимостей, приведения прав доступа и перезапуска сервисов единым скриптом deploy.sh с set -e.
Шаг 4. Убедитесь, что права на файлы после деплоя принадлежат пользователю веб-сервера, а не личной учётной записи администратора.
Шаг 5. Никогда не коммитьте .env и другие файлы с реальными секретами — используйте .env.example с пустыми плейсхолдерами вместо реальных значений.
Шаг 6. Если секрет всё же попал в репозиторий — немедленно смените его реальное значение, а не ограничивайтесь удалением файла новым коммитом.
Итог: простая схема, которая закрывает 80% практических задач
Git pull на сервере — не самая элегантная схема деплоя, но для многих проектов её более чем достаточно: она проста в настройке, понятна любому, кто хоть немного знаком с Git, и не требует поддержки отдельной CI/CD-инфраструктуры.
Главное — соблюдать базовую дисциплину: не хранить секреты в репозитории, приводить права доступа в порядок после каждого обновления и оформлять деплой единым скриптом, а не набором команд, набираемых вручную каждый раз из памяти. Эти простые правила закрывают подавляющее большинство практических проблем, с которыми сталкиваются на этой схеме.
Если проект перерос простой git pull и нужна автоматизация тестирования и деплоя — следующий логичный шаг разобран в статье про CI/CD с GitHub Actions. Если же нужна помощь с настройкой деплоя на конкретном сервере — оставьте заявку внизу страницы.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Чем git pull отличается от git fetch?
git fetch скачивает изменения из удалённого репозитория, но не применяет их к текущей рабочей копии, тогда как git pull — это фактически fetch с последующим автоматическим слиянием (merge) изменений в текущую ветку; для сервера, где нужно сразу получить актуальный код, используется именно pull.
Можно ли просто скопировать файлы на сервер вместо git pull?
Технически можно, но это лишает возможности быстро откатиться к предыдущей версии, теряет историю изменений на самом сервере и усложняет диагностику, какая именно версия кода сейчас развёрнута — git pull даёт всё это почти бесплатно при минимальной настройке.
Что делать, если после git pull изменённые файлы принадлежат не тому пользователю?
Явно указать владельца после обновления командой chown -R www-data:www-data /путь/к/проекту (или другого пользователя, от которого работает веб-сервер) — это стоит делать автоматически как часть скрипта деплоя, а не забывать вручную после каждого обновления.
Можно ли деплоить продакшн прямо из ветки main без промежуточных шагов?
Можно для небольших проектов, но правильнее иметь хотя бы минимальный процесс — тестирование перед мержем в main и, желательно, отдельную ветку или окружение для staging, чтобы изменения проверялись перед попаданием на боевой сервер.
Что произойдёт, если в рабочей директории на сервере есть незакоммиченные изменения при git pull?
Git откажется выполнять pull с сообщением о конфликте, если изменения затрагивают те же строки, что обновляются из удалённого репозитория — на сервере таких локальных правок в принципе не должно быть, любая ручная правка файлов проекта в обход Git на продакшне считается плохой практикой.
Достаточно ли удалить .env из репозитория новым коммитом, если он туда случайно попал?
Нет — файл останется в истории Git и будет доступен через git log и просмотр старых коммитов сколько угодно долго; единственно надёжное решение — считать все секреты в этом файле скомпрометированными и немедленно их сменить (сменить пароли, перевыпустить ключи API), а уже потом чистить историю репозитория.
Как посмотреть, что именно изменилось в файле перед коммитом?
Командой git diff для ещё не добавленных в индекс изменений или git diff --staged для уже добавленных через git add — обе команды показывают построчные различия между текущим состоянием файла и последним коммитом.
Нужно ли добавлять в .gitignore файлы, которые уже закоммичены в репозиторий?
.gitignore не действует на уже отслеживаемые Git файлы — их сначала нужно явно убрать из индекса командой git rm --cached, и только после этого правило в .gitignore начнёт работать и предотвратит повторное попадание файла в будущие коммиты.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.