Аудит безопасности сервера: чек-лист
Пошаговый чек-лист аудита безопасности Linux-сервера: SSH, firewall, лишние сервисы, обновления, учётные записи, логи, права доступа и сроки TLS-сертификатов — с командами для проверки каждого пункта.
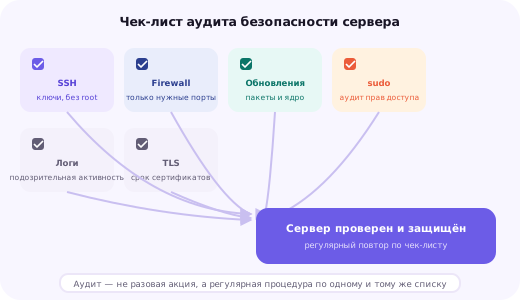
Зачем нужен формальный чек-лист, а не «общее ощущение безопасности»
Администратор, работающий с сервером каждый день, склонен считать его безопасным просто по факту отсутствия видимых проблем — сайт открывается, ошибок в логах не видно, писем от хостера с жалобами не приходило. Это ощущение обманчиво: большинство успешных компрометаций серверов не проявляются заметными симптомами месяцами, а слабые места вроде забытого открытого порта или устаревшего пакета с известной уязвимостью не дают о себе знать, пока их кто-то целенаправленно не поищет.
Чек-лист превращает абстрактную задачу «проверить безопасность» в конечный список конкретных, проверяемых пунктов, каждый из которых можно закрыть одной или двумя командами. Это не значит, что прохождение чек-листа гарантирует полную защищённость — новые уязвимости появляются постоянно, а нестандартные конфигурации требуют дополнительного внимания за пределами базового списка. Но регулярное прохождение по фиксированному набору проверок ловит подавляющее большинство типичных проблем, накапливающихся на сервере со временем: забытые тестовые доступы, неотозванные ключи уволенных сотрудников, службы, поднятые «на минутку для отладки» и оставшиеся работать годами.
Эта статья построена как последовательность разделов-проверок: SSH, firewall и открытые порты, обновления пакетов, учётные записи и sudo, логи на предмет следов компрометации, права доступа к чувствительным файлам и сроки действия TLS-сертификатов. Каждый раздел даёт не только команду для проверки текущего состояния, но и объяснение, что именно считается нормой, а что — поводом для дальнейшего разбирательства.
Проверка 1: доступ по SSH
SSH — самая частая точка входа для автоматизированного перебора паролей, поэтому его конфигурация проверяется в первую очередь. Первый и самый однозначный пункт — вход по паролю должен быть отключён в пользу ключей, а вход под root напрямую — запрещён вовсе.
grep -E "^(PasswordAuthentication|PermitRootLogin|Port)" /etc/ssh/sshd_configЗначения PasswordAuthentication no и PermitRootLogin no — это минимальный ожидаемый результат; если директивы вообще нет в файле, действует значение по умолчанию, которое на многих дистрибутивах разрешает то, что здесь запрещать не следует, поэтому явное указание параметра важнее, чем полагаться на дефолт. Смена порта с 22 на нестандартный не является мерой безопасности в строгом смысле — она лишь снижает шум от автоматических сканеров в логах, — но как дополнительный слой в связке с ключами и fail2ban вполне оправдана.
Второй пункт — какие ключи реально авторизованы для входа. Стоит открыть файл authorized_keys для каждой активной учётной записи и убедиться, что там нет ключей, назначение которых уже никто не помнит, особенно ключей от подрядчиков или временных сотрудников, чей доступ давно должен был закончиться.
cat /home/*/.ssh/authorized_keys /root/.ssh/authorized_keys 2>/dev/nullЕсли на сервере настроена двухфакторная аутентификация по SSH через TOTP, стоит также проверить, что модуль pam_google_authenticator действительно подключён в PAM-конфигурации, а не просто установлен, но не активирован — установленный, но не подключённый модуль создаёт ложное ощущение защищённости.
Проверка 2: firewall и реально открытые порты
Правила firewall на бумаге и реальное состояние системы — не всегда одно и то же: правило могло быть добавлено вручную командой iptables и не сохранено, потеряться после перезагрузки, или сервис мог начать слушать порт, для которого правило firewall никогда не прописывалось явно, полагаясь на политику по умолчанию.
ufw status verbose
ss -tulpn | grep LISTEN
Ключевая проверка здесь — сопоставление двух списков: того, что firewall разрешает пропускать, и того, что реально слушает порты на сервере через ss -tulpn. Любой порт, который слушается, но не должен быть доступен извне (например, порт базы данных, привязанный не к 127.0.0.1, а ко всем интерфейсам), — это находка, требующая немедленного исправления либо в конфигурации самого сервиса, либо явным запрещающим правилом firewall.
Отдельно стоит проверить, не осталось ли на сервере служб, поднятых для разовой задачи и забытых — тестовый веб-сервер на нестандартном порту, временно открытый для отладки Redis без пароля, или административная панель, которую когда-то давно открыли наружу для удобства и забыли закрыть. Список запущенных процессов с сетевой активностью через ss даёт исчерпывающий ответ на вопрос «что вообще слушает сеть на этом сервере прямо сейчас», без необходимости гадать по документации или памяти о том, что когда-то настраивалось.
Проверка 3: обновления пакетов и известные уязвимости
Устаревший пакет с публично известной уязвимостью — один из самых частых векторов автоматизированной компрометации: сканеры массово ищут серверы с конкретными уязвимыми версиями ПО, и промедление с обновлением измеряется не месяцами, а иногда днями с момента публикации CVE.
apt list --upgradable 2>/dev/null | grep -i security
unattended-upgrades --dry-run -d
Если unattended-upgrades ещё не настроен, стоит включить его именно в режиме обновления только пакетов безопасности, оставив плановые обновления версий ядра, PHP или базы данных на ручной контроль — автоматическое обновление патчей безопасности снижает окно уязвимости без риска неожиданного изменения поведения приложения.
dpkg -l | grep -i linux-image
uname -r
Отдельная и часто упускаемая проверка — расхождение между установленной версией ядра и версией, которая реально работает: обновление ядра пакетным менеджером не применяется до перезагрузки, поэтому сервер может формально иметь патч от известной уязвимости на диске, но продолжать работать на старом, уязвимом ядре в памяти до следующей перезагрузки или использования механизма livepatch.
Проверка 4: учётные записи и права sudo
Со временем на сервере накапливаются учётные записи, назначение которых никто уже не помнит: тестовые аккаунты, доступы для подрядчиков, выполнивших разовую задачу, или записи бывших сотрудников, доступ которых формально должен был быть отозван при увольнении, но фактически остался активным.
getent passwd | awk -F: '$3 >= 1000 {print $1, $3, $6}'
lastlog | grep -v "Never logged in"
Учётная запись, которая существует, но не использовалась месяцами, — не всегда проблема сама по себе, но повод задать вопрос «зачем она вообще активна». Отдельно стоит свериться со списком людей, у которых доступ к серверу должен быть на текущий момент по организационным причинам, — расхождение между этим списком и списком реально активных учётных записей типично находится именно во время такого рода проверки, а не проактивно, когда сотрудник увольняется.
grep -Po '^sudo:.*:\K.*' /etc/group
cat /etc/sudoers.d/* 2>/dev/null
Права sudo стоит проверять на предмет избыточной широты: правило вида ALL=(ALL) NOPASSWD: ALL для учётной записи, которой на самом деле нужно перезапускать только один конкретный сервис, — классический пример прав «на всякий случай», расширяющих поверхность атаки без реальной необходимости. Более узкое правило, разрешающее конкретные команды без запроса пароля, закрывает ту же практическую задачу с существенно меньшим риском.
Проверка 5: логи на предмет следов компрометации
Логи — единственный источник, который может рассказать о том, что уже произошло, а не только о текущем состоянии конфигурации, поэтому их просмотр — обязательная часть аудита, даже когда явных признаков проблем нет.
grep "Failed password" /var/log/auth.log | awk '{print $(NF-3)}' | sort | uniq -c | sort -rn | head -20
journalctl -u sshd --since "-7 days" | grep -i "accepted"
Второй запрос — список успешных входов — заслуживает не меньшего внимания, чем список неудачных: массовые неудачные попытки с одного IP — это обычный фоновый шум интернета, а вот успешный вход с IP-адреса или в необычное время суток, которое не соответствует обычному графику работы администраторов, требует прямого выяснения, кто и зачем заходил в этот момент.
Стоит также проверить историю команд административных учётных записей и историю установленных пакетов на предмет действий, которые никто из команды не совершал сознательно — история bash легко подделывается злоумышленником со сброшенным HISTFILE, поэтому её отсутствие или подозрительные пробелы во времени сами по себе являются сигналом, а не просто нейтральным фактом.
last -a | head -30
grep " install " /var/log/dpkg.log | tail -30
Проверка 6: права доступа к чувствительным файлам и каталогам
Слишком широкие права на файлы с секретами — конфигурации приложения с паролями от базы данных, приватные SSH-ключи, файлы окружения (.env) — редко приводят к немедленным сбоям и поэтому годами остаются незамеченными, пока не станут звеном в цепочке компрометации при другой, отдельно взятой уязвимости.
find /var/www -name ".env" -perm /o+r -exec ls -l {} \;
find / -maxdepth 3 -name "*.pem" -o -name "id_rsa" 2>/dev/null | xargs ls -l
Правильные права для приватного SSH-ключа — 600 (чтение и запись только владельцем), для файла .env с секретами приложения — как правило 640 или строже, с владельцем и группой, соответствующими пользователю, от имени которого работает веб-сервер. Права 644 или тем более 666 на такие файлы означают, что любой локальный пользователь системы, включая процессы, работающие с ограниченными привилегиями другого приложения на этом же сервере, может прочитать секреты, не относящиеся к его собственной задаче.
Отдельная категория риска — резервные копии конфигурационных файлов, оставленные редактором или самим администратором рядом с оригиналом (config.php.bak, wp-config.php.old) в директории, доступной веб-серверу напрямую: такие файлы часто не обрабатываются PHP-интерпретатором и отдаются как обычный текст, что превращает случайную резервную копию в прямую утечку паролей от базы данных при простом обращении по HTTP.
Проверка 7: сроки действия TLS-сертификатов
Просроченный TLS-сертификат — не всегда проблема безопасности в строгом смысле, но с точки зрения аудита это индикатор более широкой проблемы: если процесс продления сертификатов не отслеживается должным образом, велика вероятность, что и другие рутинные, но важные процессы (обновления, ротация ключей, ревизия доступов) организованы так же слабо.
echo | openssl s_client -servername example.com -connect example.com:443 2>/dev/null | openssl x509 -noout -datesДля серверов с Let's Encrypt стоит отдельно проверить, что автоматическое продление через certbot действительно работает, а не просто настроено формально в cron, но давно перестало срабатывать из-за изменившейся конфигурации веб-сервера или недоступности порта 80/443 в момент проверки.
certbot certificates
certbot renew --dry-run
Если на сервере несколько доменов или поддоменов с отдельными сертификатами, стоит пройтись по каждому индивидуально — распространённая ошибка аудита состоит в проверке только основного домена, тогда как забытый тестовый или устаревший поддомен с истёкшим сертификатом продолжает существовать в DNS и рано или поздно попадётся клиенту или сканеру уязвимостей в качестве видимой проблемы.
Проверка 8: резервные копии и их реальная восстанавливаемость
Формальное наличие резервных копий и их реальная пригодность для восстановления — разные вещи, и аудит безопасности без проверки этого пункта рискует создать ложное чувство защищённости: бэкапы могут исправно создаваться месяцами, но оказаться нечитаемыми или неполными именно в тот момент, когда они понадобятся после инцидента.
ls -lh /var/backups/ 2>/dev/null
find /path/to/backups -name "*.sql.gz" -mtime -1
gunzip -t /path/to/backups/latest.sql.gz && echo "архив цел"
Ключевой вопрос аудита — не «есть ли расписание бэкапов в cron», а «когда последний раз кто-то реально восстанавливал данные из резервной копии и проверял результат». Резервная копия, ни разу не протестированная восстановлением на отдельном стенде, — это предположение о работоспособности, а не проверенный факт, и именно в аудите безопасности разумно зафиксировать дату последнего тестового восстановления как отдельный проверяемый пункт наравне с датой последнего бэкапа.
Отдельно стоит убедиться, что копии хранятся не только на том же физическом сервере, что и исходные данные, — резервная копия, лежащая на том же диске, что и продакшен-база, не защищает от отказа этого диска или от компрометации сервера целиком, и минимальная гигиена бэкапов требует хотя бы одной копии на физически отдельном хранилище или у другого провайдера.
Как оформить результаты аудита и что делать дальше
Аудит без письменной фиксации результатов теряет большую часть ценности: находки без записи забываются уже через неделю, а без даты предыдущей проверки невозможно понять, стала ли ситуация лучше или хуже с прошлого раза. Достаточно простого документа или тикета с датой, списком проверенных пунктов и статусом каждого — «ок», «исправлено», «требует внимания, но не критично» — без необходимости в сложной системе управления уязвимостями для большинства проектов.
Найденные проблемы стоит явно приоритизировать, а не бросаться исправлять всё одновременно: открытый порт базы данных наружу или доступный по паролю root — это критично и требует немедленного исправления, тогда как забытая неактивная учётная запись без sudo-прав или устаревшая версия второстепенного пакета без публичной уязвимости может подождать до планового окна обслуживания.
Наконец, чек-лист имеет смысл пересматривать и дополнять по результатам собственного опыта — если конкретный проект регулярно сталкивается с одним и тем же классом проблем (например, забытыми тестовыми доступами после каждого релиза), в чек-лист стоит добавить отдельный специфичный для этого проекта пункт, а не полагаться только на универсальный список.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Как часто нужно проводить аудит безопасности сервера?
Базовый чек-лист стоит прогонять не реже раза в квартал, а также после любого значимого события — смены состава команды с доступом к серверу, миграции на новое приложение, обнаружения подозрительной активности в логах или после публичного разглашения уязвимости в используемом ПО.
С чего начать, если аудит проводится впервые и сервер уже давно в эксплуатации?
С инвентаризации: сначала нужно выяснить, что вообще на сервере запущено и кто имеет к нему доступ, прежде чем закручивать гайки — список открытых портов, список пользователей с sudo и список запущенных сервисов дают базовую картину, от которой уже можно отталкиваться при исправлении конкретных проблем.
Достаточно ли одного чек-листа или нужен автоматический сканер?
Чек-лист и автоматический сканер решают разные задачи и хорошо дополняют друг друга: чек-лист заставляет пройти по конкретным пунктам осмысленно и с пониманием контекста, а инструмент вроде Lynis быстро находит то, что человек мог упустить по невнимательности, особенно на большом парке серверов.
Что делать, если в ходе аудита найдены следы компрометации?
Не спешить с чисткой логов и переустановкой — сначала зафиксировать состояние системы (снимок дисков, копии логов, список процессов и сетевых соединений) для последующего разбора, изолировать сервер от сети, если компрометация подтверждена, и только потом переходить к восстановлению из чистого бэкапа, а не к попытке вручную вычистить заражённую систему.
Нужно ли проверять права доступа к файлам, если сервер работает без проблем?
Да, отсутствие видимых проблем ничего не говорит о безопасности прав доступа — слишком широкие права на конфигурационные файлы с паролями или на директории с приватными ключами обычно не вызывают сбоев в работе приложения, но открывают возможность для повышения привилегий или кражи учётных данных при малейшей другой уязвимости.
Стоит ли включать автоматические обновления безопасности на продакшен-сервере?
В большинстве случаев да, но выборочно: unattended-upgrades стоит настраивать так, чтобы автоматически ставились только патчи безопасности, а не любые обновления пакетов — это снижает окно уязвимости без риска, что ночное обновление major-версии базы данных внезапно сломает продакшен.
Как проверить, не осталось ли на сервере забытых учётных записей бывших сотрудников?
Командой getent passwd для системных пользователей и списком последних входов через last и lastlog для оценки активности каждой учётной записи; отдельно стоит сверить список пользователей с sudo-правами (visudo -c или содержимое /etc/sudoers.d/) со списком людей, у которых должен быть административный доступ на текущий момент.
Как быстро проверить срок действия TLS-сертификата без захода в панель управления?
Командой openssl s_client, подключившись к нужному хосту и порту 443, с последующей передачей вывода в openssl x509 -noout -dates — это покажет даты notBefore и notAfter сертификата, который сервер реально отдаёт клиентам, без необходимости искать файл сертификата на диске или заходить в веб-интерфейс.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.