Что делать при DDoS-атаке: план действий
Пошаговый план на случай реальной DDoS-атаки: как отличить её от всплеска легитимного трафика, что делать в первые минуты, какие временные меры реально помогают и как подготовиться к следующему разу.
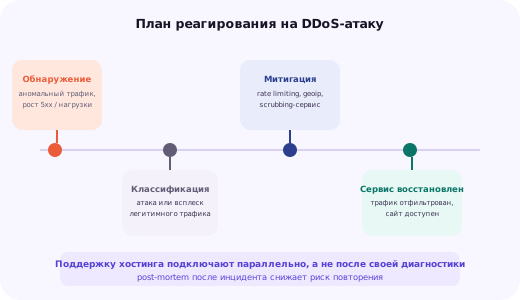
Как отличить атаку от органического всплеска трафика
Первый и самый важный шаг — не начинать паниковать и предпринимать резкие действия, а быстро, но методично отличить реальную атаку от легитимного всплеска посещаемости: например, после публикации на крупной площадке, вирусного поста в соцсетях или рекламной кампании, случайно совпавшей по времени с проблемами на сервере. Ошибочная реакция на легитимный трафик как на атаку (агрессивная блокировка целых диапазонов IP) может причинить сайту больше вреда, чем сама предполагаемая проблема.
Ключевые признаки, указывающие именно на атаку, а не на органический рост: аномально узкий набор источников трафика при огромном общем объёме запросов, повторяющиеся запросы к одному и тому же URL или к заведомо несуществующим страницам, user-agent, не соответствующий реальным браузерам или вовсе отсутствующий, отсутствие типичного для реальных посетителей поведения (переходов между страницами, времени на странице), а также резкий рост именно в показателях, специфичных для конкретного типа атаки — исчерпание полосы пропускания канала, аномально высокое число полуоткрытых TCP-соединений, или чрезмерная нагрузка на конкретный ресурсоёмкий эндпоинт приложения.
# быстрый обзор самых частых источников в логе nginx за последние минуты
tail -n 20000 /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20
Легитимный всплеск обычно показывает широкое распределение по десяткам или сотням разных IP-адресов с разумным числом запросов от каждого, тогда как при атаке этот же анализ часто выявляет либо небольшую группу адресов с огромным числом запросов каждый (характерно для менее изощрённых атак), либо, наоборот, огромное число уникальных адресов с относительно небольшим числом запросов от каждого — это типичный признак распределённой атаки через ботнет, где каждый отдельный источник сам по себе не выглядит подозрительно, но их совокупность создаёт разрушительную нагрузку.
Определение типа атаки: волюметрическая, протокольная, прикладного уровня
Дальнейшие действия сильно зависят от того, на каком уровне сетевого стека происходит атака, поэтому классификация — не академическое упражнение, а прямая основа для выбора конкретной меры реагирования. Волюметрические атаки (volumetric) нацелены на исчерпание полосы пропускания канала связи чистым объёмом трафика — сервер и приложение при этом могут быть технически исправны, но канал физически не пропускает легитимные запросы сквозь поток мусорного трафика.
Протокольные атаки (protocol attacks) эксплуатируют особенности сетевых протоколов транспортного и сетевого уровня — классический пример, SYN flood, когда атакующий инициирует огромное число TCP-соединений, не завершая рукопожатие, исчерпывая таблицу полуоткрытых соединений на сервере или на промежуточном сетевом оборудовании, что не обязательно требует большого объёма трафика в мегабитах, но эффективно исчерпывает ограниченный ресурс — количество одновременных состояний соединений.
Атаки прикладного уровня (application layer, уровень L7) — наиболее сложные для отличения от легитимного трафика, поскольку выглядят как обычные, синтаксически корректные HTTP-запросы, но нацелены на конкретный ресурсоёмкий эндпоинт приложения — например, страницу поиска с тяжёлым запросом к базе данных, эндпоинт генерации PDF-отчёта, или страницу авторизации — вызывая перегрузку не сети, а самого приложения или базы данных при относительно скромном объёме сетевого трафика.
# проверка числа соединений в состоянии SYN_RECV — признак SYN flood
ss -n state syn-recv | wc -l
Практический смысл этой классификации: волюметрическую атаку в большинстве случаев физически невозможно остановить средствами самого сервера, поскольку канал забит ещё до того, как трафик доходит до него, — здесь нужно вмешательство на уровне сети провайдера или специализированного scrubbing-сервиса. Атаки прикладного уровня, напротив, часто можно смягчить локально — через rate limiting, кэширование ответов или временное отключение конкретного дорогого эндпоинта.
Первые минуты: что проверить и куда обратиться
В первые минуты после обнаружения аномалии стоит параллельно, а не последовательно, выполнить несколько действий. Во-первых, зафиксировать текущую картину — сохранить срез логов веб-сервера, показатели сетевой нагрузки и загрузки сервера на момент обнаружения проблемы, поскольку эти данные понадобятся и для диагностики прямо сейчас, и для последующего разбора после завершения атаки.
vnstat -l
# либо более простая моментальная проверка интерфейса
ifstat -t 1 5
Во-вторых, немедленно связаться с поддержкой хостинга или провайдера защиты от DDoS, если он уже подключён, — это не альтернатива, а параллельное действие вашей собственной диагностике: волюметрическая атака выше определённого объёма физически требует вмешательства на уровне сети провайдера, будь то фильтрация трафика на его оборудовании или подключение стороннего scrubbing-сервиса, и чем раньше провайдер узнает о проблеме, тем быстрее он сможет отреагировать на своей стороне.
В-третьих, если для сайта уже подключён CDN или обратный прокси (например, тот же провайдер защиты от DDoS перед сервером), стоит немедленно проверить его собственную панель или дашборд — многие такие сервисы уже начинают автоматически фильтровать аномальный трафик до того, как он вообще доходит до вашего сервера, и часть работы по смягчению атаки может уже выполняться без вашего дополнительного вмешательства, что важно знать перед тем, как предпринимать резкие меры вручную на самом сервере.
Временные меры на уровне сервера: rate limiting и блокировки
Если атака классифицирована как прикладного уровня и её объём не исчерпывает канал целиком, ряд мер можно применить прямо на сервере для немедленного облегчения нагрузки, пока идёт более фундаментальное решение через провайдера или scrubbing-сервис. Ограничение частоты запросов (rate limiting) на уровне nginx — быстрая и эффективная мера против атак, характеризующихся большим числом запросов с ограниченного набора источников.
limit_req_zone $binary_remote_addr zone=ddos_zone:20m rate=10r/s;

server {
    location / {
        limit_req zone=ddos_zone burst=20 nodelay;
    }
}
Если анализ логов показал явную концентрацию атакующего трафика в конкретных диапазонах IP-адресов или в конкретном географическом регионе, временная блокировка через firewall или geoip-модуль nginx может быстро снять значительную часть нагрузки — с обязательным осознанием, что это заблокирует и легитимных посетителей из тех же диапазонов, поэтому такую меру стоит применять как временную и снимать сразу после того, как атака прекратится или будет взята под контроль иным способом.
# временная блокировка конкретной подсети через iptables
iptables -I INPUT -s 203.0.113.0/24 -j DROP
Для атак с явной эксплуатацией конкретного тяжёлого эндпоинта (например, страница поиска или генерации отчёта) временное отключение или упрощение именно этого функционала — вплоть до показа статической заглушки вместо динамической обработки — часто оказывается быстрее и надёжнее, чем попытка отфильтровать вредоносные запросы к нему на уровне сети, поскольку эти запросы синтаксически неотличимы от легитимных обращений к той же странице.
Подключение scrubbing-сервиса и работа через провайдера защиты
Scrubbing-сервис — специализированная инфраструктура, принимающая на себя весь входящий к сайту трафик (обычно через изменение DNS-записи домена на адреса провайдера защиты вместо прямого адреса вашего сервера), фильтрующая вредоносный трафик на своих мощностях и пропускающая к реальному серверу только уже очищенный, легитимный поток запросов. Для проекта, ранее не подключавшего такую защиту, экстренное подключение в разгар атаки возможно, но требует времени на распространение изменения DNS-записи по миру, которое не происходит мгновенно.
Именно поэтому проекты с реальным риском серьёзных атак разумно подключают такую защиту заранее, в спокойное время, а не в момент, когда сайт уже недоступен и счёт идёт на минуты, — многие провайдеры при этом позволяют держать защиту в режиме ожидания с минимальными затратами до фактического наступления атаки, что снимает дилемму между постоянными расходами на защиту и риском долгого простоя при экстренном подключении задним числом.
Если прямой IP-адрес сервера стал известен атакующим в обход CDN или scrubbing-сервиса (что случается, если сайт раньше работал без такой защиты, или если IP-адрес утёк через письмо сервера, DNS-историю, или отдельный поддомен, не прикрытый тем же прокси), атака может продолжаться напрямую на сервер даже после подключения защиты для основного домена — в такой ситуации требуется дополнительно настроить firewall так, чтобы сервер принимал соединения только от известных адресов провайдера защиты, либо сменить сам IP-адрес сервера.
Коммуникация с пользователями во время атаки
Пока техническая команда занимается смягчением атаки, отдельная и не менее важная задача — коммуникация с пользователями и клиентами, если сайт критичен для их работы. Полное молчание во время видимого простоя сайта обычно воспринимается хуже, чем честное и краткое сообщение о происходящем, даже без точных технических подробностей и точного времени восстановления.
Практическое решение — заранее подготовленная статическая страница статуса (размещённая на инфраструктуре, не зависящей от атакуемого сервера, например, на отдельном простом хостинге или через сторонний сервис статус-страниц), на которую можно оперативно направить трафик или на которую можно сослаться в социальных сетях и по другим каналам связи, не задействующим сам атакуемый сервер.
Важно избегать в публичных сообщениях излишне детальной технической информации о характере атаки и предпринимаемых контрмерах — эта информация может быть полезна самим атакующим для адаптации тактики, тогда как для пользователей достаточно короткого и честного сообщения о временных проблемах с доступностью сервиса и ожидаемых сроках восстановления, по мере их прояснения.
После атаки: разбор инцидента и подготовка к следующему разу
Как только атака прекратилась и сайт стабильно работает в обычном режиме, соблазн просто выдохнуть и вернуться к обычным задачам велик, но именно разбор произошедшего инцидента определяет, насколько лучше будет подготовлена инфраструктура к следующей атаке — а вероятность повторной атаки на ранее атакованный ресурс отнюдь не нулевая, особенно если причина изначальной уязвимости к атаке не была устранена.
Разбор должен ответить на несколько конкретных вопросов: сколько времени прошло от начала атаки до её обнаружения, и можно ли сократить это время через более быстрый мониторинг или оповещения; какие именно временные меры реально помогли, а какие оказались бесполезны или излишне навредили легитимному трафику; была ли атака направлена на конкретную уязвимость приложения (тяжёлый эндпоинт, отсутствие ограничения частоты запросов на форме или API), которую стоит исправить на уровне кода, а не только смягчать на уровне инфраструктуры при каждой новой атаке.
По итогам разбора стоит обновить сам план реагирования — этот документ не должен оставаться неизменным годами: контактные данные провайдера защиты, актуальные команды диагностики под текущую конфигурацию сервера, обновлённый список тяжёлых эндпоинтов приложения, требующих защиты через rate limiting или кэширование. План, который команда проверяет и уточняет после каждого реального инцидента (а в идеале — периодически прогоняет как учебную тревогу и без реальной атаки), реально сокращает время реакции при следующем случае, тогда как план, написанный один раз и забытый в ящике стола, часто оказывается устаревшим именно в тот момент, когда он действительно нужен.
Как не спутать атаку с обычным техническим сбоем
Не всякая внезапная недоступность сайта — это атака, и потратить время на подготовку к отражению несуществующей DDoS-атаки, пропустив при этом обычную техническую причину, — тоже реальный риск, увеличивающий время простоя. Прежде чем переходить к мерам противодействия атаке, стоит быстро исключить более простые и распространённые причины: исчерпание места на диске (в частности, из-за разросшихся логов), достижение лимита открытых файловых дескрипторов или процессов PHP-FPM при обычном, не аномальном росте нагрузки, сбой на стороне базы данных, или проблема у самого хостинг-провайдера, не связанная с вашим конкретным сервером.
df -h
free -h
systemctl status nginx php-fpm mysql
tail -n 100 /var/log/nginx/error.log
Отличительный признак именно атаки, а не внутреннего сбоя, — сервер и его сервисы при проверке изнутри (по SSH, если доступ ещё сохранился) выглядят технически исправными и отвечают на локальные запросы, но при этом либо сетевой канал показывает аномально высокую входящую нагрузку, либо число одновременных соединений или процессов резко превышает типичные значения именно из-за внешнего потока запросов, а не из-за внутренней проблемы самого приложения или базы данных.
Если доступ по SSH к серверу тоже пропал одновременно с недоступностью сайта, это скорее говорит в пользу волюметрической атаки, забившей входящий канал целиком (в этом случае даже служебный трафик управления не может пробиться до сервера), тогда как при атаке прикладного уровня или протокольной атаке умеренного масштаба SSH-доступ и возможность диагностики с самого сервера обычно сохраняются, поскольку атака нацелена на конкретный сервис или порт, а не на канал в целом.
Сохранение доказательств для провайдера и возможного разбирательства
Помимо непосредственного технического реагирования, стоит с самого начала атаки сохранять данные, которые пригодятся и провайдеру защиты для более точной настройки фильтрации, и, при необходимости, для последующего обращения в правоохранительные органы или к юристам, если атака была направлена целенаправленно и связана, например, с шантажом или конкурентной борьбой.
# сохранение среза логов и статистики за период атаки в отдельный архив
mkdir -p /root/incident-2026-11-05
cp /var/log/nginx/access.log /root/incident-2026-11-05/
netstat -s > /root/incident-2026-11-05/netstat-stats.txt
tar czf /root/incident-2026-11-05.tar.gz /root/incident-2026-11-05/
Полезно сохранить не только сырые логи веб-сервера, но и любые уведомления или скриншоты панели провайдера защиты от DDoS с графиками объёма отфильтрованного трафика, точное время начала и окончания атаки по вашим собственным наблюдениям, а также переписку с поддержкой хостинга — если атака окажется частью более широкой кампании (например, целенаправленное вымогательство с требованием выкупа за прекращение атаки, что иногда встречается на практике), эти материалы понадобятся для обращения в правоохранительные органы, и собирать их постфактум по памяти намного сложнее, чем сохранить сразу по горячим следам.
Отдельно стоит зафиксировать бизнес-последствия инцидента — приблизительную продолжительность простоя, оценку потерянных заказов или трафика, если это применимо к характеру проекта, — это не только полезно для внутреннего разбора и обоснования будущих инвестиций в защиту, но и может потребоваться для претензий к провайдеру, если условия предоставления услуг предусматривают компенсацию за простой, вызванный недостаточной защитой на его стороне.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Чем эта статья отличается от общей статьи про защиту от DDoS?
Статья про основы защиты от DDoS описывает превентивные меры, которые настраиваются заранее, до атаки. Эта статья — операционный план действий именно в момент, когда атака уже происходит: как её распознать в реальном времени, какие шаги предпринять немедленно и в каком порядке, и что делать после того, как атака закончилась.
Как быстро понять, что это действительно DDoS, а не вирусный всплеск популярности сайта?
Главные отличия — характер источников трафика и профиль запросов. Легитимный всплеск обычно приходит с разнообразных IP-адресов и user-agent, соответствующих реальным браузерам, с нормальным распределением по страницам сайта. Атака чаще показывает aномально узкий набор источников или паттернов запросов, обращения к одному и тому же URL или к несуществующим страницам, и не соответствующий органическому трафику user-agent.
Стоит ли сразу звонить в поддержку хостинга, или сначала попробовать разобраться самому?
Оба действия стоит начинать параллельно, а не последовательно — обращение в поддержку хостинга или к провайдеру защиты от DDoS не блокирует вашу собственную диагностику, а крупная волюметрическая атака в любом случае требует вмешательства на уровне сети провайдера, которое нельзя выполнить с самого сервера.
Поможет ли просто перезагрузить сервер во время атаки?
Как правило нет — если атака действительно продолжается, перезагруженный сервер снова столкнётся с тем же потоком вредоносного трафика сразу после подъёма сети, а на время перезагрузки сайт станет полностью недоступен даже для легитимных посетителей, к которым он мог бы частично оставаться доступен при частичной деградации без полной перезагрузки.
Можно ли просто заблокировать все запросы из другой страны, если атака идёт оттуда?
Технически можно через geoip-блокировку на уровне nginx или firewall, и это иногда действительно оправданная временная мера при явной географической концентрации атакующих адресов — но стоит понимать, что это заблокирует и легитимных посетителей из этого региона, и применять такую меру нужно как временную, оценив соотношение пользы и потерянного легитимного трафика.
Что такое scrubbing-сервис и всегда ли он нужен?
Scrubbing-сервис — специализированная инфраструктура провайдера защиты от DDoS, которая принимает на себя весь трафик к сайту, отфильтровывает вредоносные запросы и пропускает к серверу только легитимный трафик. Для постоянно высокого риска атак его разумно держать включённым всегда, а для проекта с низким профилем риска — активировать по факту начала атаки или держать в режиме ожидания с быстрой активацией.
Нужно ли менять IP-адрес сервера после атаки?
Если атака была направлена конкретно на IP-адрес сервера (а не на домен через известный DNS), и адрес сервера утёк или стал известен атакующим в обход CDN или защитного прокси, смена IP-адреса вместе с настройкой доступа к серверу только через защищённый прокси или CDN может быть оправданной мерой, чтобы прямой путь к серверу перестал быть известен.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.