Восстановление сервера после сбоя: план действий
Что такое RTO и RPO простыми словами, что нужно подготовить заранее для восстановления после аварии, порядок действий при отказе сервера, восстановление из бэкапа или пересборка с нуля, и как тестировать план DR до того, как он реально понадобится.
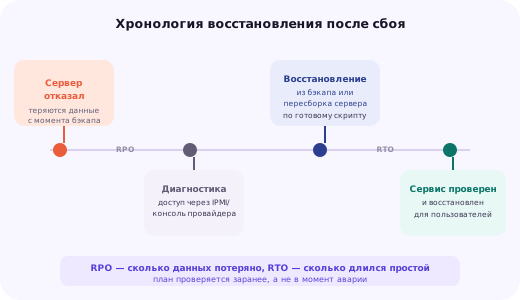
RTO и RPO: два числа, вокруг которых строится любой план
Прежде чем говорить о конкретных действиях при аварии, полезно определить два показателя, вокруг которых строится весь план восстановления. RTO (Recovery Time Objective) — это допустимое время простоя: сколько минут или часов может пройти между началом аварии и полным восстановлением работы сервиса, прежде чем это станет неприемлемым для бизнеса. RPO (Recovery Point Objective) — это допустимая потеря данных, измеряемая временным интервалом: если последний бэкап был снят шесть часов назад, а сервер упал прямо сейчас, RPO этой системы фактически равен шести часам потерянных изменений.
Эти два показателя напрямую определяют требования к инфраструктуре резервного копирования и мониторинга: жёсткий RPO в несколько минут требует непрерывной репликации данных или очень частых инкрементальных бэкапов, тогда как RPO в сутки допускает обычное ночное резервное копирование. Жёсткий RTO в считаные минуты требует заранее подготовленной резервной инфраструктуры, готовой принять нагрузку почти немедленно, тогда как RTO в несколько часов оставляет время на разворачивание нового сервера с нуля.
Важно определить RTO и RPO осознанно, а не постфактум во время аварии — для интернет-магазина с оборотом в реальном времени приемлемый RPO может составлять минуты, тогда как для внутреннего корпоративного сайта с редкими изменениями контента вполне достаточно суточного бэкапа. Именно эти два числа, согласованные заранее с владельцем бизнеса, а не только с технической командой, задают весь остальной план восстановления, разбираемый ниже.
Что подготовить заранее: резервные копии, которые реально восстанавливаются
Наличие файла с расширением .sql.gz или .tar.gz в каталоге бэкапов ещё не означает наличие рабочего плана восстановления — критична не сама копия, а подтверждённая возможность из неё восстановиться. Стандартное для отрасли правило 3-2-1 задаёт минимальную структуру: три копии данных, на двух разных типах носителей, одна из которых хранится географически отдельно от основного сервера.
# Пример многоуровневой схемы хранения по правилу 3-2-1
# 1. Оригинал: рабочие данные на сервере
# 2. Локальная копия: снапшот на отдельном диске / другом сервере в том же ДЦ
# 3. Удалённая копия: S3-совместимое хранилище в другом регионе или у другого провайдера
Территориально отдельная копия защищает не только от отказа одного диска или сервера, но и от куда более редкого, но куда более разрушительного сценария — физического инцидента в конкретном дата-центре (пожар, затопление, длительное отключение электричества), при котором и основной сервер, и локальная резервная копия в том же здании окажутся недоступны одновременно.
Резервные копии без регулярной проверки восстановления — это иллюзия защищённости, а не защита: файл бэкапа может оказаться повреждён, скрипт архивации мог тихо начать создавать пустые файлы несколько недель назад, а формат экспорта данных мог измениться при обновлении используемого ПО без соответствующего обновления скрипта восстановления. Регулярное тестовое восстановление (хотя бы раз в месяц на отдельном тестовом сервере) — единственный надёжный способ убедиться, что бэкапы действительно рабочие, а не только формально существуют.
Что подготовить заранее: документация конфигураций
Помимо данных, для полного восстановления сервиса нужна конфигурация: версии установленного ПО, настройки веб-сервера и базы данных, список запущенных сервисов и их зависимостей, сетевые настройки, установленные SSL-сертификаты и правила файрвола. Без этой информации восстановление данных на новом сервере не воссоздаёт полноценно работающий сервис — оно лишь возвращает данные, оставляя воспроизведение всей окружающей инфраструктуры на память администратора в момент стресса.
# Минимальный набор для документирования конфигурации сервера
dpkg --get-selections > packages-list.txt
nginx -T > nginx-full-config.txt
crontab -l > crontab-backup.txt
systemctl list-unit-files --state=enabled > enabled-services.txt
Инфраструктура как код — конфигурация серверов, описанная в виде Ansible-плейбуков, Terraform-модулей или хотя бы подробных bash-скриптов установки — решает эту задачу наиболее надёжно, поскольку такое описание уже является исполняемой инструкцией по восстановлению, а не текстом, который нужно интерпретировать и применять вручную под давлением времени. Даже без полноценной автоматизации простой текстовый документ с последовательностью шагов установки и настройки критичного ПО заметно сокращает время восстановления по сравнению с восстановлением по памяти.
Документацию конфигурации, как и сами бэкапы, стоит хранить отдельно от документируемого сервера и обновлять при каждом значимом изменении инфраструктуры — устаревший на полгода документ, не отражающий последние изменения в конфигурации, вводит в заблуждение в момент аварии не меньше, чем полное отсутствие документации.
Что подготовить заранее: доступы и учётные данные
В момент аварии критично важно иметь быстрый доступ к панели управления хостингом или облачным провайдером, консоли управления сервером (IPMI, VNC, панель виртуализации), DNS-панели для возможного переключения записей на резервный сервер, и учётным данным для восстановления из бэкапа (доступ к хранилищу S3, ключи шифрования резервных копий, если они используются).
Хранение всех этих данных нужно организовать так, чтобы к ним был доступ у более чем одного человека в команде и чтобы этот доступ не зависел от инфраструктуры, которая как раз может быть недоступна во время аварии — например, если единственная копия паролей хранится в базе данных менеджера паролей, синхронизируемого через сам упавший сервер, доступ к паролям окажется заблокирован именно тогда, когда он нужнее всего.
# Чек-лист доступов для плана восстановления
# - Панель хостинг-провайдера / облака (логин, 2FA-резервные коды)
# - Консоль управления сервером: IPMI/KVM/VNC
# - DNS-провайдер (для смены A-записи на резервный IP)
# - Хранилище резервных копий (S3, ключи доступа)
# - Ключ шифрования бэкапов, если применяется
# - Контакты ответственных лиц и их резервных замен
Использование менеджера паролей с общим доступом для команды, работающего независимо от восстанавливаемой инфраструктуры, и распечатанной или иным образом офлайн-доступной резервной копии критичных 2FA-кодов — практичное решение этой проблемы, регулярно упускаемое даже опытными командами, полагающимися на единственный канал доступа к учётным данным.
Немедленные шаги при обнаружении, что сервер не отвечает
Первая минута после алерта о недоступности сервера определяет, насколько быстро начнётся осмысленное восстановление, а не паническое перебирание случайных действий. Первый шаг — подтвердить, что проблема действительно на стороне сервера, а не в собственной сети, у провайдера мониторинга или временного сетевого сбоя на промежуточном узле: проверка с другого канала связи (мобильный интернет вместо офисного, сторонний онлайн-сервис проверки доступности) отсекает ложные тревоги за несколько секунд.
ping server-ip
curl -I https://example.ru --max-time 5
ssh user@server-ip -o ConnectTimeout=5
Если сервер действительно недоступен по SSH, следующий шаг — попытаться получить доступ через альтернативный канал: консоль управления IPMI/KVM у выделенного сервера или консоль виртуализации у VPS, которая работает независимо от сетевого стека самой операционной системы и может показать, что происходит, даже когда SSH-демон не отвечает или сеть внутри системы не поднялась.
Параллельно с попытками восстановить доступ стоит сразу же уведомить заинтересованные стороны о начале инцидента — короткое сообщение "мы знаем о проблеме, разбираемся" снимает часть давления и предотвращает параллельные, несогласованные попытки исправить ситуацию разными людьми одновременно, что на практике нередко только усложняет диагностику.
Восстановление из бэкапа или пересборка с нуля
Когда причина недоступности сервера ясна и требует полного восстановления, встаёт выбор между двумя путями: восстановить данные и конфигурацию на прежнем или новом сервере из резервной копии, или развернуть сервер заново с нуля (через заранее подготовленный образ, скрипт автоматической настройки или инфраструктуру как код) и накатить на него только данные.
Восстановление из полного бэкапа обычно быстрее для небольших проектов с относительно небольшим объёмом данных и несложной конфигурацией — весь процесс сводится к развёртыванию сохранённого состояния почти как есть. Для больших объёмов данных, особенно при загрузке резервной копии из удалённого хранилища с ограниченной скоростью канала, время восстановления может оказаться неожиданно долгим и превысить целевой RTO.
# Оценка времени восстановления заранее, а не во время реальной аварии
time aws s3 cp s3://backups-bucket/latest-dump.sql.gz . --endpoint-url https://s3.example.com
du -sh latest-dump.sql.gz
Пересборка с нуля через заранее подготовленный образ или автоматизированный скрипт установки (Ansible, Terraform, готовый Docker-образ приложения) часто оказывается быстрее и надёжнее для сложной конфигурации, поскольку исключает риск накопленных за годы работы сервера случайных ручных изменений, не попавших ни в один бэкап конфигурации, — новый сервер получается предсказуемо чистым и полностью соответствующим документации. Оптимальная практика для большинства проектов — сочетание обоих подходов: инфраструктура и конфигурация восстанавливаются автоматизированным разворачиванием с нуля, а собственно данные (база данных, файлы пользователей) — из резервной копии поверх уже готовой чистой системы.
Порядок восстановления: что поднимать в первую очередь
При восстановлении многокомпонентного проекта — база данных, файловое хранилище, веб-сервер, очереди задач, кэш — редко есть смысл поднимать всё одновременно: разумнее восстановить компоненты в порядке зависимостей, чтобы каждый следующий шаг сразу можно было проверить на работающем предыдущем слое.
Типичный порядок для веб-приложения: сначала база данных (без неё бессмысленно поднимать что-либо ещё), затем файловое хранилище с пользовательским контентом, затем сам веб-сервер и приложение, и только в последнюю очередь — вспомогательные сервисы вроде очередей фоновых задач или систем полнотекстового поиска, отсутствие которых временно снижает функциональность, но не блокирует базовую работу сайта для посетителей.
На каждом шаге стоит явно проверять работоспособность компонента, прежде чем переходить к следующему, а не поднимать всё подряд и разбираться с ошибками только в самом конце — так проще локализовать, на каком именно шаге восстановления что-то пошло не так, вместо диагностики полностью собранной, но неработающей системы целиком.
Коммуникация с пользователями и заказчиком во время инцидента
Пока идёт техническое восстановление, отдельная и не менее важная задача — держать заинтересованные стороны в курсе происходящего, не оставляя их в неведении. Полное молчание во время длительного простоя воспринимается заметно хуже, чем регулярные короткие обновления статуса, даже если сами обновления сводятся к "продолжаем восстановление, ожидаемое время окончания уточняется".
Для проектов с достаточной аудиторией имеет смысл заранее подготовить отдельный канал коммуникации, независимый от основной инфраструктуры, — отдельная статус-страница на стороннем хостинге, аккаунт в мессенджере или социальной сети, специально предназначенный для оповещений о доступности сервиса. Если единственный канал связи с пользователями — сам сайт, который сейчас недоступен, у команды физически нет способа сообщить о статусе восстановления тем, кто больше всего в этом статусе нуждается.
Внутри команды не менее важно назначить одного человека, ответственного за коммуникацию наружу, отдельно от тех, кто непосредственно занимается техническим восстановлением, — совмещение обеих ролей в момент стресса нередко приводит к тому, что обновления статуса откладываются "на потом", а это самое "потом" наступает уже после того, как недовольство пользователей успевает вырасти непропорционально фактической серьёзности проблемы.
Post-mortem: разбор инцидента после восстановления
Восстановление работы сервиса — не финальная точка инцидента, а начало следующего важного шага: разбора причин и обновления плана восстановления с учётом полученного опыта. Post-mortem проводится без поиска виноватого конкретного человека, а с фокусом на систему — что в мониторинге, бэкапах или процедурах позволило проблеме произойти или затянуло время восстановления.
# Структура минимального post-mortem документа
# 1. Хронология: когда началось, когда обнаружено, когда устранено
# 2. Первопричина (root cause), а не только симптом
# 3. Что сработало хорошо в процессе восстановления
# 4. Что можно улучшить: мониторинг, бэкапы, процедуры, документация
# 5. Конкретные задачи с ответственными и сроками
Ключевая практическая ценность post-mortem — превращение разового болезненного опыта в конкретные улучшения плана DR: если восстановление заняло дольше ожидаемого RTO, разбор должен ответить, что именно замедлило процесс — недостаточная скорость загрузки бэкапа, отсутствие готового скрипта развёртывания, задержка с получением доступа к консоли управления — и внести соответствующее изменение в план до следующего инцидента, а не полагаться, что в следующий раз повезёт больше.
Тестирование плана восстановления до того, как он реально понадобится
План восстановления, ни разу не проверенный на практике, с высокой вероятностью содержит ошибки: устаревшие учётные данные, неполный список зависимостей, забытый шаг конфигурации, о котором помнил только один сотрудник, давно покинувший команду. Единственный способ обнаружить эти пробелы заранее, а не во время реального инцидента, — регулярно проводить учебное восстановление на отдельном тестовом сервере.
Практика учебного восстановления должна максимально повторять реальный сценарий: тот, кто выполняет восстановление, следует исключительно документации плана, не полагаясь на собственную память о том, "как обычно это делается" — если документация неполна или неточна, это должно проявиться именно на этом шаге, а не во время настоящей аварии. Полезно также периодически менять исполнителя учебного восстановления, чтобы план не зависел от знаний одного конкретного человека.
Для проектов с жёстким RTO стоит замерять фактическое время учебного восстановления и сравнивать с целевым показателем — если тренировка стабильно занимает вдвое больше времени, чем заложено в RTO, это сигнал пересмотреть либо саму инфраструктуру резервного копирования и разворачивания, либо реалистичность заявленного целевого времени восстановления.
Итоги: план DR как страховка, которую проверяют заранее
План восстановления после сбоя — это не документ, написанный один раз и убранный в архив, а живой набор договорённостей и подготовленных ресурсов: согласованные RTO и RPO, рабочие и регулярно проверяемые резервные копии, документированная конфигурация, доступный независимо от аварии список учётных данных, и отработанный на практике порядок действий.
Разница между организацией, для которой авария сервера — управляемый, хоть и неприятный эпизод, и организацией, для которой та же авария превращается в многочасовой или многодневный кризис, почти никогда не в том, что первая заранее знала о конкретной причине будущего сбоя — она в том, что первая заранее подготовила и проверила план на случай любого сбоя, а вторая рассчитывала разобраться по ходу дела.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Чем RTO отличается от RPO?
RTO (Recovery Time Objective) — это допустимое время простоя, то есть сколько часов или минут может занять восстановление, прежде чем это станет неприемлемым для бизнеса. RPO (Recovery Point Objective) — это допустимый объём потери данных, измеряемый временем: если бэкапы делаются раз в сутки, при аварии в худшем случае теряются данные за почти целые сутки, и это и есть фактический RPO вашей системы резервного копирования.
Нужен ли план восстановления малому проекту с одним сервером?
Да, даже минимальный план — какие есть бэкапы, где хранятся доступы, кому звонить — заметно сокращает время простоя по сравнению с ситуацией, когда всё это приходится вспоминать или искать в момент аварии, находясь в состоянии стресса и под давлением недовольных пользователей.
Восстановление из бэкапа всегда быстрее, чем пересборка сервера с нуля?
Не всегда — восстановление большого объёма данных из бэкапа (особенно из удалённого хранилища с ограниченной скоростью загрузки) может занять больше времени, чем развернуть новый сервер из заранее подготовленного образа или скрипта автоматической настройки и накатить на него только актуальные данные.
Как часто нужно тестировать план восстановления?
Универсального ответа нет, но практика показывает, что план, ни разу не проверенный на практике, с высокой вероятностью содержит ошибки или устаревшие данные — разумный минимум для активного продакшн-проекта — хотя бы раз в квартал или после каждого значимого изменения инфраструктуры.
Что делать в первую минуту после обнаружения, что сервер недоступен?
Сначала подтвердить, что проблема действительно на стороне сервера, а не в собственной сети или у провайдера мониторинга (проверка с другого канала связи или через сторонний сервис), затем попытаться получить доступ через альтернативный канал — консоль управления (IPMI, VNC у VPS), а не только SSH, который сам может быть недоступен из-за проблемы на сервере.
Где лучше хранить документацию по восстановлению — на самом сервере?
Нет, документацию и учётные данные, необходимые для восстановления, нужно хранить отдельно от восстанавливаемого сервера — если единственная копия плана DR лежит на упавшем сервере, план бесполезен именно тогда, когда нужен больше всего.
Обязательно ли делать post-mortem после каждого инцидента?
Для значимых инцидентов, повлиявших на пользователей или бизнес, — да: разбор без поиска виноватых, а с фокусом на то, что можно улучшить в мониторинге, бэкапах или процедурах, заметно снижает вероятность повторения того же сценария в будущем.
Сколько резервных копий нужно хранить одновременно?
Общепринятое правило — правило 3-2-1: минимум три копии данных, на двух разных типах носителей, одна из которых хранится территориально отдельно от основного сервера — это защищает не только от отказа диска, но и от физического инцидента в дата-центре и от случайного повреждения самих бэкапов.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.