Аптайм-мониторинг сайта: как узнать о падении раньше пользователей
Чем внешний мониторинг доступности сайта отличается от мониторинга ресурсов сервера, как настроить простую проверку через cron и curl самостоятельно и что даёт полноценный сервис аптайм-мониторинга.
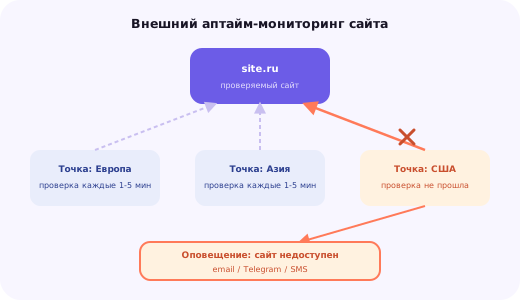
Два разных вопроса: «здоров ли сервер» и «доступен ли сайт»
Мониторинг ресурсов сервера — загрузки CPU, использования RAM, свободного места на диске — отвечает на вопрос, здоров ли сам сервер как физическая или виртуальная машина. Базовый набор таких метрик и инструментов для их отслеживания подробно разобран в статье про мониторинг сервера. Это необходимый, но не достаточный уровень контроля: сервер может показывать полностью здоровые метрики по всем параметрам, а сайт при этом быть недоступен для реальных посетителей по причинам, которые внутренний мониторинг ресурсов просто не видит.
Внешний аптайм-мониторинг проверяет другой, более прямой вопрос: действительно ли сайт отвечает нормальным образом с точки зрения постороннего наблюдателя, находящегося вне вашей инфраструктуры. Этот тип проверки ловит заметно более широкий класс реальных сбоев — истёкший SSL-сертификат, из-за которого браузер отказывается открывать страницу вообще, несмотря на полностью исправный сервер; ошибку в DNS-записи, из-за которой домен указывает не на тот адрес; зависший процесс веб-сервера, который перестал принимать новые соединения, хотя сам процесс всё ещё числится запущенным в системе; или блокировку на уровне сетевого оборудования между сервером и внешним миром, которую изнутри сервера просто не видно.
Оба типа мониторинга дополняют друг друга и решают разные задачи: внутренний мониторинг ресурсов помогает заранее увидеть надвигающуюся проблему (растущая загрузка, заканчивающееся место на диске) и предотвратить её до того, как она станет критичной, тогда как внешний мониторинг доступности — это последний рубеж, который сообщает о факте уже случившегося падения сайта, независимо от его конкретной причины, зачастую даже раньше, чем об этом успеют написать реальные пользователи в поддержку.
Почему проверку нужно запускать не с того же сервера
Самая частая ошибка при первой попытке настроить мониторинг своими силами — разместить проверочный скрипт прямо на том же сервере, где работает сам сайт. Логика кажется разумной («проверим, отвечает ли сайт локально»), но она упускает главный сценарий, ради которого вообще нужен мониторинг: если сервер полностью недоступен, завис или потерял сетевое соединение целиком, скрипт проверки, запущенный на нём же, точно так же перестанет выполняться — и никакого уведомления просто не будет отправлено именно в тот момент, когда оно нужнее всего.
Правильная архитектура — вынести саму проверку на устройство, физически и сетевым образом независимое от проверяемого сервера: другой VPS, домашний компьютер с постоянным включением, или, что удобнее и надёжнее всего для критичных проектов, специализированный внешний сервис. Единственное требование к машине, откуда запускается проверка, — её собственная сеть и доступность в интернет не должны зависеть от того же провайдера, дата-центра или маршрута, что и проверяемый сайт, иначе при сбое именно в этой общей точке пропадёт и сайт, и возможность узнать об этом.
DIY-подход: простой скрипт на cron и curl
Для базового сценария полноценный отдельный сервис не обязателен — минимальная рабочая проверка укладывается в несколько строк shell-скрипта, использующего curl для запроса к сайту и проверки кода ответа. Общий принцип настройки задач по расписанию через cron подробно разобран в отдельной статье базы знаний.
#!/bin/bash
URL="https://example.ru"
STATUS=$(curl -s -o /dev/null -w "%{http_code}" --max-time 10 "$URL")

if [ "$STATUS" != "200" ]; then
  echo "Сайт $URL вернул код $STATUS вместо 200 в $(date)" | mail -s "Сайт недоступен: $URL" you@example.ru
fi
Скрипт запрашивает страницу с ограничением времени ожидания в 10 секунд (параметр --max-time — критически важен, иначе при полностью зависшем сервере запрос может ждать ответа бесконечно долго, блокируя саму проверку) и сравнивает полученный HTTP-код ответа с ожидаемым 200. Если код отличается — например, сервер отдаёт 500 из-за ошибки в коде, 502 из-за упавшего PHP-FPM или вовсе не отвечает — скрипт отправляет письмо на почту через стандартную утилиту mail, для работы которой на сервере, откуда запускается проверка, должна быть настроена отправка почты.
*/5 * * * * /home/user/check-site.shТакая запись в crontab запускает скрипт каждые пять минут — этого достаточно для большинства небольших и средних проектов, где задержка в несколько минут до получения уведомления о падении не критична для бизнеса. Более требовательным проектам имеет смысл сократить интервал до одной минуты, учитывая при этом, что более частые проверки создают чуть больше шансов зацепить случайную кратковременную сетевую заминку и отправить ложную тревогу.
Более надёжная проверка: не только код ответа, но и содержимое
Проверка одного лишь HTTP-кода ответа имеет слепое пятно: сервер вполне может вернуть корректный код 200, но при этом отдать пользователю страницу с текстом ошибки PHP, пустую заглушку от неправильно настроенного кэша, или страницу технического обслуживания CMS — формально это «200 OK», а фактически сайт для реального посетителя не работает так, как должен.
CONTENT=$(curl -s --max-time 10 "$URL")
if ! echo "$CONTENT" | grep -q "Ожидаемый текст на странице"; then
  echo "Сайт вернул неожиданное содержимое в $(date)" | mail -s "Проблема на сайте" you@example.ru
fi
Практичный выбор строки для такой проверки — что-то, что гарантированно присутствует на исправно работающей странице и одновременно вряд ли появится случайно в тексте ошибки: название компании в футере, конкретный элемент навигации, уникальная фраза из шаблона. Такая проверка требует чуть больше настройки при первом запуске, но ловит заметно более широкий и коварный класс проблем, чем одна лишь проверка кода ответа.
Что добавляет полноценный сервис аптайм-мониторинга сверх DIY-скрипта
Специализированные сервисы аптайм-мониторинга решают несколько задач, которые сложно и часто нецелесообразно воспроизводить самостоятельно с нуля. Во-первых, проверка сразу из нескольких географически разных точек — сайт может быть прекрасно доступен из региона, где физически находится ваш DIY-сервер проверки, и при этом недоступен для пользователей на другом континенте из-за проблем на конкретном сетевом маршруте, которые одна-единственная точка проверки просто не увидит.
Во-вторых, разнообразие каналов оповещения — не только письмо на почту, которое можно не заметить вовремя среди других писем или пропустить, если оно попало в спам, а SMS, звонок на телефон, push-уведомление в мобильном приложении, интеграция с мессенджерами и корпоративными системами оповещения дежурных инженеров. Для критичного для бизнеса сайта разница между письмом, прочитанным через час, и звонком, разбудившим ответственного человека посреди ночи, может стоить реальных потерянных заказов.
В-третьих, публичная страница статуса (status page) — отдельная страница, куда сервис автоматически публикует информацию о текущей доступности и историю инцидентов, на которую можно ссылаться из уведомлений клиентам вместо того, чтобы вручную писать и рассылать сообщения о каждом сбое. И в-четвёртых — накопленная историческая статистика аптайма в процентах за месяц, квартал и год, которая полезна и для внутреннего контроля качества инфраструктуры, и как аргумент в переговорах с провайдером, если процент доступности систематически ниже обещанного в SLA.
Интервал проверки и порог оповещения: как не создать эффект «мальчика, который кричал волк»
Слишком редкая проверка — раз в час или реже — означает, что сайт может быть недоступен значительную часть времени прежде, чем об этом вообще станет известно, что сводит на нет саму цель раннего обнаружения проблемы. Слишком частая проверка — каждые несколько секунд — без реальной необходимости создаёт избыточную, пусть и небольшую, дополнительную нагрузку и увеличивает шанс поймать случайную единичную сетевую заминку, которая сама по себе разрешится за секунду и не является настоящей проблемой.
Разумный интервал для большинства сайтов — от одной до пяти минут, в зависимости от того, насколько критична для бизнеса каждая минута простоя. Не менее важен порог подтверждения: отправлять оповещение не после первой же неудачной проверки, а после двух или трёх подряд, с небольшим интервалом между ними — это фильтрует единичные сетевые заминки, DNS-задержки или временную перегрузку сервера, которые сами исчезают за секунды, и оставляет только действительно устойчивые проблемы, требующие реакции.
Обратная сторона слишком мягкого порога подтверждения — задержка реального оповещения о настоящем падении сайта на те самые несколько минут, которые нужны для подтверждения. Здесь важен баланс, соответствующий конкретному проекту: для сайта с оплатой в реальном времени и высокой ценой минуты простоя разумно требовать подтверждение всего в два цикла проверки с коротким интервалом между ними, тогда как для менее критичного проекта можно позволить себе три-четыре цикла и меньше ложных тревог.
Проверка HTTPS и сертификата — отдельная, но связанная задача
Помимо самой доступности страницы, стоит отдельно проверять и то, что HTTPS-сертификат сайта не истёк и не истечёт в ближайшие дни — просроченный сертификат делает сайт недоступным для подавляющего большинства пользователей, поскольку современные браузеры блокируют переход на сайт с недействительным сертификатом предупреждением на весь экран, даже если сам сервер и содержимое страницы полностью исправны.
echo | openssl s_client -servername example.ru -connect example.ru:443 2>/dev/null | openssl x509 -noout -enddateПри использовании автоматического продления сертификата через Let's Encrypt, подробно разобранного в отдельной статье, риск истечения сертификата по забывчивости минимален, но стоит держать в уме, что сбой автоматизации продления (например, из-за смены конфигурации веб-сервера или временной недоступности сервиса выдачи сертификатов) может остаться незамеченным вплоть до момента, когда сертификат фактически истечёт, — отдельная периодическая проверка срока действия сертификата служит независимой подстраховкой на случай такого сбоя.
Что делать после получения оповещения о падении
Само по себе оповещение о недоступности сайта — это сигнал начать диагностику, а не автоматическое знание точной причины. Первый практический шаг — попробовать открыть сайт вручную из другого места и с другого устройства, чтобы исключить локальную проблему именно с точкой проверки, а не с самим сайтом.
Дальше стоит проверить код ответа и заголовки через curl -I напрямую, заглянуть в панель мониторинга ресурсов сервера на предмет аномальной загрузки CPU, памяти или диска, и посмотреть последние строки логов веб-сервера и PHP на предмет явных ошибок в момент начала проблемы. Наличие заранее настроенного и понятного алгоритма первых шагов диагностики экономит драгоценные минуты в момент реального инцидента по сравнению с попыткой сообразить план действий с нуля в состоянии стресса от сработавшей тревоги.
Полезная практика — вести короткий журнал инцидентов: дата и время, длительность простоя, установленная причина и предпринятые меры. Со временем такой журнал помогает заметить повторяющиеся закономерности — например, если сайт систематически падает в одно и то же время суток или после определённого типа действий (обновление плагина, рост трафика от рекламной кампании), это прямой сигнал искать и устранять именно эту конкретную первопричину, а не бесконечно реагировать на симптом.
Проверяйте не только сайт, но и сам механизм оповещения
Отдельная и часто упускаемая деталь — сам канал оповещения тоже может незаметно сломаться: почтовый ящик, на который приходят письма от cron-скрипта, переполнился и перестал принимать новую почту, письма стали попадать в спам после смены настроек почтового сервера, или у сервиса мониторинга истёк срок действия интеграции с мессенджером, и об этом никто не узнал, потому что до этого момента реальных сбоев сайта просто не случалось и оповещения не понадобилось отправлять.
Практическая защита от этого — периодически, например раз в месяц, намеренно проверять весь путь оповещения целиком: временно завершить процесс веб-сервера на тестовом окружении или указать в скрипте проверки заведомо недоступный адрес, чтобы убедиться, что письмо или уведомление действительно доходит до нужного человека тем каналом и в то время, когда это ожидается. Мониторинг, оповещения которого никогда не тестировались вживую, рискует оказаться бесполезным ровно в тот момент, когда он нужнее всего, — обнаружить сломанный канал оповещения в момент реального инцидента многократно хуже, чем найти и исправить его заранее на спокойном плановом тесте.
То же самое касается сервисов, использующих несколько каналов одновременно — если настроены и почта, и SMS, и интеграция с мессенджером, стоит время от времени убеждаться, что рабочими остаются все три канала, а не только тот, который случайно проверялся в последний раз. Дублирование каналов оповещения теряет смысл, если все они на самом деле полагаются на одну и ту же точку отказа — например, единственный номер телефона ответственного администратора, который может быть недоступен именно в момент инцидента.
Мониторинг не только главной страницы, но и ключевых сценариев
Проверка одной лишь главной страницы сайта — хорошая база, но она не гарантирует, что работают остальные важные для бизнеса разделы: оформление заказа в интернет-магазине, форма обратной связи, авторизация в личном кабинете. Главная страница вполне может отдавать код 200 и корректно выглядеть, в то время как отдельный, критичный для конверсии сценарий сломан из-за локальной ошибки именно в этом разделе — например, после обновления плагина оплаты или изменения интеграции с внешним сервисом доставки.
Для сайтов, где конкретные сценарии напрямую связаны с доходом, разумно завести отдельные проверки именно для них — не только запрос кода ответа страницы оформления заказа, но, при наличии такой возможности, тестовый проход через ключевые шаги сценария целиком. Это требует больше усилий на настройку, чем простая проверка кода ответа главной страницы, но именно поломка платежного сценария при внешне полностью исправном остальном сайте — один из самых дорогих для бизнеса и одновременно долго остающихся незамеченными без специального мониторинга видов сбоев.
Разумный компромисс для небольшого проекта без ресурсов на сложную настройку — хотя бы добавить отдельную, пусть и простую по логике, проверку для двух-трёх самых важных с точки зрения бизнеса страниц сайта в дополнение к главной, а не ограничиваться единственной точкой контроля, которая покрывает лишь малую часть реальных сценариев использования сайта.
Итог: минимальный набор для старта
Для любого сайта, за доступностью которого важно следить, минимальный разумный набор — независимая от самого сервера точка проверки (другой сервер или внешний сервис), интервал проверки от одной до пяти минут, порог подтверждения в два-три цикла перед отправкой оповещения, и хотя бы один надёжный канал оповещения, который точно не будет пропущен в критичный момент.
Для небольшого некоммерческого проекта простого DIY-скрипта на cron и curl, описанного выше, вполне достаточно и обычно хватает надолго. Для сайта, напрямую связанного с доходом бизнеса, разумно перейти на специализированный сервис мониторинга ради проверки из нескольких точек мира, множественных каналов оповещения и публичной страницы статуса — разница в стоимости такого сервиса обычно несопоставима с ценой одного пропущенного часа простоя интернет-магазина в высокий сезон. Если нужна помощь с настройкой мониторинга и алгоритма реакции на инциденты для вашего проекта — оставьте заявку внизу страницы.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Достаточно ли мониторинга ресурсов сервера, чтобы знать, что сайт работает?
Нет, сервер может выглядеть полностью здоровым по CPU и памяти, а сайт при этом быть недоступен по внешним причинам — истёкший SSL-сертификат, ошибка в DNS, зависший процесс веб-сервера или блокировка на уровне сети провайдера. Внешняя проверка нужна именно для того, чтобы поймать эти случаи.
Можно ли обойтись без платного сервиса и мониторить сайт самостоятельно?
Да, для базового сценария вполне достаточно cron-задачи с curl на другом сервере — этого хватает, чтобы вовремя узнавать о недоступности сайта; платный сервис добавляет удобства вроде проверок из нескольких точек мира и разных каналов оповещения, но не является строго обязательным для небольшого проекта.
Почему нельзя запускать проверку на том же сервере, где работает сайт?
Если сервер полностью упал или потерял сеть, скрипт проверки, запущенный на нём же, тоже перестанет выполняться и не отправит никакого уведомления — сама проверка должна выполняться независимо от объекта проверки, иначе она бесполезна именно в критичный момент.
Как часто нужно проверять доступность сайта?
Для большинства сайтов разумный интервал — от 1 до 5 минут: это позволяет узнать о проблеме быстро, но не создаёт избыточную нагрузку и не генерирует ложные тревоги от единичных сетевых заминок.
Что делать, если проверка один раз показала ошибку, а сайт на самом деле работает?
Настроить подтверждение проблемы — например, отправлять оповещение только после двух-трёх подряд неудачных проверок, а не после первой же, чтобы отфильтровать случайные кратковременные сетевые заминки и не создавать эффект «мальчика, который кричал волк».
Нужно ли проверять не только код ответа, но и содержимое страницы?
Да, для более надёжной проверки полезно искать в ответе конкретную строку, которая всегда присутствует на исправно работающей странице, — сервер может отвечать кодом 200, но при этом отдавать страницу с ошибкой PHP или пустой заглушкой вместо реального контента.
Отличается ли мониторинг доступности сайта от мониторинга доступности API или отдельного сервиса?
Принцип тот же самый — периодический внешний запрос с проверкой ответа, но для API часто важнее проверять не только код ответа, а корректность конкретных полей в теле ответа и время его получения, что требует чуть более сложного скрипта проверки, чем для обычной HTML-страницы.
Может ли внешний мониторинг сам стать причиной нагрузки на сайт?
При разумном интервале проверки (раз в одну-пять минут) нагрузка от мониторинга исчезающе мала по сравнению с обычным трафиком сайта — заметной проблемой это становится только при неправильно настроенном слишком частом опросе в интервале в несколько секунд без необходимости.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.