Индексы в MySQL: как ускорить запросы
Как устроены B-tree индексы, почему порядок столбцов в составном индексе критичен, что такое покрывающий индекс, как читать EXPLAIN и когда лишний индекс замедляет запись вместо ускорения чтения.
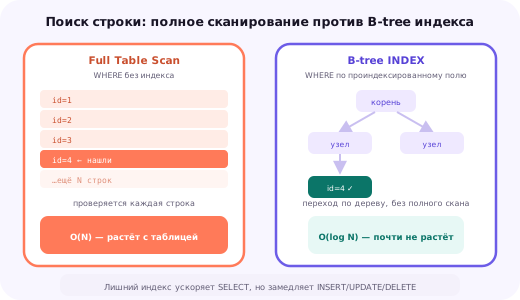
Зачем нужны индексы и как устроен B-tree
Без индекса поиск нужных строк в таблице MySQL выполняется полным последовательным сканированием — сервер читает каждую строку таблицы по порядку и проверяет, удовлетворяет ли она условиям запроса. На таблице в несколько сотен строк это происходит практически мгновенно и незаметно, но на таблице в миллионы строк такой подход превращается в одну из самых частых причин медленной работы сайта, поскольку время выполнения растёт линейно вместе с размером таблицы, вне зависимости от того, сколько строк реально удовлетворяет условию.
Индекс — это отдельная структура данных, хранящая значения индексируемых столбцов в отсортированном виде вместе со ссылками на физическое расположение соответствующих строк в таблице. Подавляющее большинство индексов в MySQL (для движка InnoDB, используемого по умолчанию) реализованы через структуру B-tree (сбалансированное дерево) — она устроена так, что поиск конкретного значения, диапазона значений или ближайшего значения выполняется за число шагов, растущее не линейно, а логарифмически относительно общего числа строк.
Практическое следствие такой структуры: поиск нужной строки среди миллиона строк по индексированному столбцу занимает не намного больше шагов, чем поиск среди тысячи строк — разница исчисляется единицами дополнительных уровней дерева, а не пропорциональным ростом времени выполнения, как при полном сканировании. Это и есть основная причина, по которой правильно спроектированный индекс способен ускорить конкретный запрос на порядки на таблице заметного размера.
Оборотная сторона этой эффективности — индекс не бесплатен: он занимает дополнительное место на диске (для составных индексов на нескольких столбцах — заметное), должен обновляться при каждой операции, меняющей индексируемые столбцы, и оптимизатор запросов MySQL должен учитывать его при построении плана выполнения каждого запроса к таблице, что тоже требует некоторых вычислительных затрат, хотя и значительно меньших, чем выигрыш от использования индекса там, где он действительно нужен.
Составные индексы и порядок столбцов
Составной индекс охватывает сразу несколько столбцов таблицы в заданном порядке, и этот порядок принципиально важен для того, сможет ли оптимизатор запросов вообще воспользоваться таким индексом для конкретного запроса. Индекс можно эффективно использовать только по непрерывному префиксу его столбцов слева направо — если индекс построен на столбцах (a, b, c), он эффективен для условий на a, на (a, b) и на (a, b, c), но не для условия только на b или только на c без участия a.
CREATE INDEX idx_customer_status_created
ON orders (customer_id, status, created_at);
Общее практическое правило подбора порядка столбцов: столбцы, участвующие в условиях точного равенства (WHERE column = значение), стоит размещать в индексе раньше столбцов, участвующих в диапазонных условиях (WHERE column > значение, BETWEEN) или сортировке через ORDER BY, — после первого диапазонного условия дальнейшие столбцы индекса уже не могут эффективно сужать поиск и используются MySQL преимущественно для избежания дополнительной сортировки результата.
EXPLAIN SELECT * FROM orders
WHERE customer_id = 42 AND status = 'paid'
ORDER BY created_at DESC;
В примере выше индекс из предыдущего блока идеально подходит под структуру запроса: customer_id и status используются в условиях точного равенства и сужают диапазон поиска в дереве индекса до минимума, а created_at в конце индекса позволяет MySQL сразу прочитать найденные строки в нужном порядке, избегая отдельного этапа сортировки результата после выборки — именно такая комбинация условий WHERE и ORDER BY чаще всего встречается в реальных запросах веб-приложений и оправдывает продуманный порядок столбцов составного индекса.
Важно понимать, что тот же индекс (customer_id, status, created_at) не поможет запросу, фильтрующему только по status без участия customer_id, — MySQL не может использовать этот индекс для эффективного поиска, минуя первый столбец, и для такого запроса потребовался бы отдельный индекс, начинающийся именно со status.
Покрывающие индексы
Покрывающий индекс (covering index) — это индекс, который содержит все столбцы, нужные для полного выполнения конкретного запроса, включая не только столбцы условий WHERE, но и столбцы, перечисленные в самом SELECT. Когда индекс покрывает запрос целиком, MySQL может ответить на запрос, читая данные только из структуры самого индекса, вообще не обращаясь к основным строкам таблицы — а это заметно быстрее обычного сценария, где по найденной в индексе ссылке требуется отдельное чтение полной строки данных с диска или из буферного пула.
CREATE INDEX idx_customer_status_created_total
ON orders (customer_id, status, created_at, total);

EXPLAIN SELECT created_at, total FROM orders
WHERE customer_id = 42 AND status = 'paid';
В этом примере добавление столбца total в конец индекса (даже несмотря на то, что он не участвует ни в условиях WHERE, ни в сортировке) превращает индекс в покрывающий для конкретного запроса, поскольку все столбцы, упомянутые в SELECT и WHERE, теперь содержатся прямо в самом индексе. В выводе EXPLAIN такой случай отражается значением "Using index" в столбце Extra — явный сигнал, что запрос обслуживается исключительно структурой индекса.
Покрывающие индексы особенно ценны для часто выполняемых запросов с ограниченным набором выбираемых столбцов — типичный пример: список последних заказов клиента с отображением лишь нескольких полей на странице личного кабинета. Добавление в индекс тех немногих столбцов, что реально показываются пользователю, может заметно снизить нагрузку на диск и буферный пул для такого частого запроса ценой относительно небольшого увеличения размера самого индекса.
Стоит избегать соблазна делать покрывающими вообще все индексы подряд, включая в них избыточное число столбцов "на всякий случай" — каждый дополнительный столбец в индексе увеличивает его физический размер и, соответственно, стоимость его обновления при каждой операции записи в таблицу, поэтому покрывающие индексы стоит проектировать целенаправленно под конкретные, действительно частые и важные запросы, а не применять эту технику повсеместно без разбора.
EXPLAIN: как читать план выполнения запроса
Ключевой инструмент для понимания, использует ли конкретный запрос индекс и насколько эффективно, — команда EXPLAIN, добавляемая перед запросом вместо его выполнения: MySQL возвращает описание плана выполнения, а не сам результат запроса.
EXPLAIN SELECT * FROM products
WHERE category_id = 15 AND price BETWEEN 1000 AND 5000
ORDER BY created_at DESC
LIMIT 20;
Столбец type в выводе EXPLAIN показывает способ доступа к данным, и его значения образуют условную шкалу от худшего к лучшему: ALL означает полное сканирование всей таблицы построчно — самый медленный вариант на таблице заметного размера; index — полное сканирование, но уже по структуре индекса, а не по самим строкам таблицы, что немного лучше, но всё ещё далеко от идеала; range — сканирование ограниченного диапазона значений индекса, типичное для условий с BETWEEN или сравнением; ref и eq_ref — поиск по точному совпадению значения индексированного столбца, самые быстрые практические варианты для условий равенства.
Столбец key показывает, какой конкретно индекс реально выбрал оптимизатор запросов из числа доступных для этой таблицы, а possible_keys — какие индексы теоретически подходили под условия запроса, но не обязательно были выбраны; расхождение между этими двумя столбцами (несколько подходящих индексов в possible_keys, но выбор явно не самого очевидного из них в key) заслуживает отдельного внимания при разборе неожиданно медленного запроса. Столбец rows даёт примерную оценку числа строк, которые оптимизатор планирует просмотреть — большое значение здесь на таблице заметного размера обычно сигнализирует о недостаточно избирательном индексе или его полном отсутствии.
Столбец Extra содержит дополнительные пометки о плане выполнения, среди которых особенно важны две: "Using filesystem" и "Using temporary" — они означают, что MySQL не смог обойтись существующими индексами для сортировки или группировки и создаёт временную структуру для дополнительной обработки результата уже после выборки данных, что почти всегда указывает на отсутствие подходящего составного индекса, покрывающего одновременно условия WHERE и порядок ORDER BY или GROUP BY в запросе.
Когда индекс мешает вместо того, чтобы помогать
Каждый индекс на таблице — это отдельная структура, которую MySQL должен синхронно обновлять при каждой операции, изменяющей индексируемые столбцы: вставке новой строки, удалении существующей или изменении значения в любом из индексируемых столбцов. Чем больше индексов у таблицы, тем больше структур обновляется при каждой такой операции, и на таблицах с интенсивной записью (журналы событий, очереди задач, счётчики) избыточное число индексов может заметно замедлить именно операции INSERT и UPDATE, а не помочь запросам на чтение.
Отдельная проблема — индексы, добавленные когда-то под конкретный запрос или отчёт, который впоследствии перестал использоваться, но сам индекс остался в структуре таблицы и продолжает замедлять запись без какой-либо пользы для чтения. Найти такие неиспользуемые индексы можно через анализ статистики обращений к ним — MySQL с включённым performance_schema ведёт учёт того, сколько раз реально обращались к каждому индексу конкретной таблицы.
SELECT object_schema, object_name, index_name, count_star
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE object_schema = 'myapp' AND count_star = 0
ORDER BY object_name;
Индексы с нулевым или крайне низким числом обращений на активно работающей таблице — хорошие кандидаты на удаление, но перед этим стоит убедиться, что статистика собиралась достаточно долго и охватила все реальные сценарии использования таблицы, включая редкие, но важные отчёты, которые могут выполняться раз в месяц, а не ежедневно, и потому не попасть в короткий период наблюдения.
Дублирующиеся индексы — ещё одна распространённая, но менее очевидная проблема: индекс на (a, b) делает избыточным отдельный индекс просто на (a), поскольку первый уже эффективно покрывает все запросы, для которых подошёл бы второй, — такое дублирование часто накапливается со временем, когда разные разработчики независимо добавляют похожие, но не идентичные индексы под похожие, но не идентичные задачи, не проверяя заранее, что уже существует в схеме таблицы.
Типы индексов помимо обычного B-tree
Хотя B-tree покрывает подавляющее большинство практических случаев, MySQL поддерживает и другие типы индексов для специфичных задач. Уникальный индекс (UNIQUE) не только ускоряет поиск, как обычный индекс, но и обеспечивает ограничение целостности — гарантирует отсутствие дублирующихся значений в индексируемом столбце или комбинации столбцов, что часто используют для email пользователей или артикулов товаров.
CREATE UNIQUE INDEX idx_users_email ON users (email);
CREATE FULLTEXT INDEX idx_articles_content ON articles (title, body);
Полнотекстовый индекс (FULLTEXT) устроен принципиально иначе, чем B-tree, и предназначен для поиска по естественному тексту — вместо точного совпадения значения он ищет вхождение слов или их сочетаний внутри текстового содержимого столбца, поддерживая ранжирование результатов по релевантности через специальную конструкцию MATCH AGAINST. Обычный B-tree индекс с оператором LIKE '%слово%' не способен эффективно решать эту задачу, поскольку префиксный поиск по индексу работает только тогда, когда искомая подстрока стоит в начале значения, а не в произвольном месте.
Для геопространственных данных (координаты, полигоны) MySQL предоставляет отдельный тип индекса SPATIAL, оптимизированный под запросы вроде "найти все точки в пределах заданной области" — такие запросы плохо ложатся на обычную одномерную структуру B-tree, рассчитанную на сравнение и сортировку скалярных значений, а не на двумерные пространственные отношения между объектами.
Для большинства обычных веб-приложений (интернет-магазины, CMS, SaaS-сервисы) базовые B-tree и уникальные индексы закрывают подавляющее большинство практических потребностей, а специализированные типы индексов стоит применять целенаправленно там, где сама природа запроса (полнотекстовый поиск, геопространственные вычисления) действительно этого требует, а не для общих задач фильтрации и сортировки.
Практический пример: от медленного запроса к оптимизированному
Рассмотрим типичный сценарий: интернет-магазин с таблицей заказов, растущей на тысячи записей в месяц, и медленно отвечающую страницу истории заказов конкретного клиента, отсортированную по дате создания в убывающем порядке.
EXPLAIN SELECT id, status, total, created_at FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 10;

-- type: ALL, rows: 850000, Extra: Using filesystort
Вывод EXPLAIN показывает type: ALL — полное сканирование всех 850 тысяч строк таблицы заказов, несмотря на то что реальному клиенту нужны лишь несколько десятков его собственных заказов, и дополнительную сортировку всего результата после выборки, поскольку данные извлекались в произвольном (по сути, физическом) порядке, а не в порядке, требуемом ORDER BY.
CREATE INDEX idx_orders_customer_created
ON orders (customer_id, created_at);
После добавления составного индекса на (customer_id, created_at) повторный EXPLAIN того же запроса покажет type: ref (поиск по точному совпадению customer_id) и отсутствие Using filesort в столбце Extra — MySQL находит нужный диапазон строк конкретного клиента напрямую по индексу и сразу читает их в требуемом порядке благодаря второму столбцу индекса, полностью избегая как сканирования всей таблицы, так и отдельного шага сортировки после выборки. На таблице такого размера разница между двумя планами выполнения — это разница между запросом, занимающим доли секунды, и запросом, ощутимо тормозящим страницу при каждом её открытии.
Типичные ошибки при работе с индексами
Добавление индекса на каждый столбец таблицы "на всякий случай" без анализа реальных запросов — раздувает размер таблицы на диске и в буферном пуле, замедляет каждую операцию записи и далеко не всегда реально используется оптимизатором для тех запросов, что выполняются на практике.
Неверный порядок столбцов в составном индексе — индекс (status, customer_id) не поможет эффективно тому же запросу, для которого нужен (customer_id, status), если условие на customer_id избирательнее, чем условие на status: порядок столбцов индекса должен соответствовать реальной структуре условий запроса, а не произвольному порядку их перечисления в WHERE.
Добавление индекса наугад без предварительного EXPLAIN проблемного запроса — часто приводит к созданию индекса, который теоретически связан с нужной таблицей, но не соответствует реальной комбинации условий конкретного медленного запроса и потому не используется оптимизатором вовсе.
Игнорирование накопившихся неиспользуемых и дублирующихся индексов на таблицах, схема которых менялась со временем, — со временем такие индексы продолжают замедлять запись, не принося пользы ни одному реальному запросу, и периодическая ревизия схемы через performance_schema стоит небольших усилий по сравнению с постоянными накладными расходами на их поддержку.
Чек-лист работы с индексами MySQL
Шаг 1. Найдите реально медленные запросы через slow query log, а не гадайте, какому запросу и какой индекс нужен без измерения.
Шаг 2. Для каждого найденного медленного запроса выполните EXPLAIN и определите, какой тип доступа (type) сейчас используется и есть ли пометки Using filesort или Using temporary в Extra.
Шаг 3. Спроектируйте составной индекс, начиная со столбцов точного равенства из WHERE и заканчивая столбцами диапазонных условий или ORDER BY, соответствующих структуре конкретного запроса.
Шаг 4. Рассмотрите превращение индекса в покрывающий для особенно часто выполняемых запросов с ограниченным набором выбираемых столбцов.
Шаг 5. Проверьте эффект добавленного индекса повторным EXPLAIN и, по возможности, замером реального времени выполнения запроса до и после.
Шаг 6. Периодически проверяйте таблицы через performance_schema на предмет неиспользуемых или дублирующихся индексов, накопившихся за время эволюции схемы.
Итог: индексы как компромисс между чтением и записью
Индексы в MySQL — не универсальное средство "просто сделать всё быстрее", а осознанный компромисс: они ускоряют операции чтения ценой дополнительного места на диске и замедления операций записи, и правильная стратегия индексирования конкретной таблицы всегда учитывает реальное соотношение чтения и записи для этой таблицы, а не применяет одинаковый подход ко всем таблицам подряд.
Основной инструмент принятия решений здесь — не интуиция, а измерение: slow query log находит реально проблемные запросы, EXPLAIN показывает, почему конкретный запрос медленный и какой индекс ему реально нужен, а статистика использования индексов через performance_schema показывает, какие из уже существующих индексов приносят пользу, а какие лишь замедляют запись без видимого выигрыша для чтения.
Освоив базовый принцип работы B-tree и логику построения составных индексов под структуру реальных запросов, дальнейшая оптимизация индексов на растущем проекте превращается из угадывания в системный процесс: новый медленный запрос анализируется через EXPLAIN, под него проектируется индекс с учётом уже существующих в таблице, а периодическая ревизия неиспользуемых индексов не даёт схеме постепенно обрастать балластом, замедляющим запись без пользы для чтения.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Почему индекс ускоряет чтение, но замедляет запись?
Индекс — это отдельная структура данных, физически хранящаяся рядом с самой таблицей и требующая обновления при каждой операции, изменяющей индексируемые столбцы: вставке новой строки, удалении существующей или изменении значения в индексируемом столбце. Чем больше индексов у таблицы, тем больше структур нужно обновить при каждой такой операции, что напрямую увеличивает время выполнения INSERT, UPDATE и DELETE.
В каком порядке нужно перечислять столбцы в составном индексе?
От столбца с наибольшей избирательностью условий равенства к столбцу, используемому для диапазонных условий или сортировки, — общее практическое правило: столбцы, участвующие в условиях равенства (WHERE column = значение), должны идти в индексе раньше столбцов, участвующих в диапазонных условиях (WHERE column > значение) или в ORDER BY, поскольку индекс можно эффективно использовать только по непрерывному префиксу его столбцов слева направо.
Что такое покрывающий индекс (covering index)?
Индекс, который содержит все столбцы, необходимые для выполнения запроса — как для условий WHERE, так и для самого списка выбираемых столбцов в SELECT, — благодаря чему MySQL может полностью ответить на запрос, читая данные только из самого индекса, не обращаясь к основным строкам таблицы вовсе, что заметно быстрее обычного использования индекса с последующим чтением строки.
Что означает "Using index" в столбце Extra вывода EXPLAIN?
Это признак того, что запрос обслуживается покрывающим индексом — MySQL нашёл все необходимые данные прямо в структуре индекса и не обращался к основным строкам таблицы для их получения, что заметно эффективнее обычного доступа через индекс с последующим чтением полной строки по найденному указателю.
Как понять, что индекс на таблице вообще не используется запросами?
Через анализ таблицы performance_schema.table_io_waits_summary_by_index_usage (или более простой способ — включить сбор статистики использования индексов и периодически проверять счётчик обращений к каждому индексу) — индекс с нулевым или крайне низким счётчиком обращений на активно работающей таблице скорее всего избыточен и только замедляет операции записи без пользы для чтения.
Нужен ли отдельный индекс на внешний ключ (foreign key)?
В MySQL с движком InnoDB индекс на столбец внешнего ключа создаётся автоматически при объявлении самого ограничения внешнего ключа, если подходящего индекса ещё не существует, — но об этом стоит помнить явно при проектировании схемы, поскольку без индекса проверка ссылочной целостности при каждой операции с внешним ключом потребовала бы полного сканирования связанной таблицы.
Что быстрее — один составной индекс из трёх столбцов или три отдельных индекса по одному столбцу?
Для запроса, использующего условия сразу по всем трём столбцам вместе, составной индекс почти всегда эффективнее — MySQL умеет комбинировать несколько отдельных индексов через механизм index merge, но это заметно менее эффективно, чем прямое использование одного составного индекса, спроектированного под конкретную комбинацию условий запроса.
Может ли добавление индекса сделать конкретный запрос медленнее?
Напрямую для чтения — практически никогда, поскольку оптимизатор запросов MySQL просто не станет использовать индекс, если сочтёт его неэффективным для конкретного запроса. Но лишний неиспользуемый индекс замедляет операции записи в эту таблицу и занимает дополнительное место на диске и в буферном пуле, что косвенно снижает общую производительность сервера.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.