Оптимизация MySQL: настройка my.cnf под реальную нагрузку
Разбираем, какие параметры MySQL реально влияют на производительность под нагрузкой: innodb_buffer_pool_size, max_connections, slow query log, EXPLAIN и почему query cache больше не выход.
Почему настройки MySQL по умолчанию не подходят для production
Стандартная установка MySQL или MariaDB из пакетного менеджера настроена крайне консервативно — так, чтобы сервис гарантированно запустился на любом, даже самом скромном по ресурсам сервере, и не претендовал на всю доступную память. Для сервера, который реально выделен под работу с базой данных и располагает несколькими гигабайтами RAM, такие настройки по умолчанию оставляют на столе значительную часть потенциальной производительности буквально без единой строчки изменений в самих запросах или структуре базы.
Разница между дефолтной и осмысленно настроенной конфигурацией на одном и том же оборудовании и с одними и теми же запросами может быть в разы — не потому, что сами запросы стали быстрее, а потому, что MySQL перестаёт постоянно обращаться к диску за данными, которые прекрасно помещаются в оперативную память, и не упирается в искусственно заниженные лимиты на число одновременных соединений или размер временных структур в памяти.
Тюнинг базы данных без понимания реального профиля нагрузки — это стрельба вслепую: сначала нужно измерить, что именно медленно и почему, а уже потом менять конкретные параметры под конкретную причину.
Общий принцип диагностики производительности СУБД
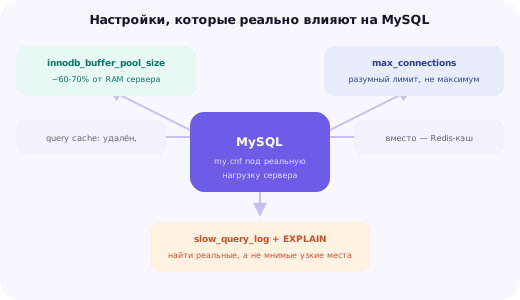
Эта статья разбирает несколько параметров, которые реально влияют на производительность подавляющего большинства сайтов на MySQL и MariaDB, — не полный список из сотен доступных настроек, а именно те немногие, изменение которых даёт измеримый практический эффект: буферный пул InnoDB, лимит одновременных соединений, поиск медленных запросов через slow log и чтение плана запроса через EXPLAIN.
Где живёт my.cnf и как безопасно тестировать изменения
Файл конфигурации MySQL называется my.cnf (или mysqld.cnf) и его конкретное расположение зависит от дистрибутива: на Ubuntu и Debian это обычно /etc/mysql/mysql.conf.d/mysqld.cnf, на CentOS и других RHEL-подобных системах — /etc/my.cnf. Дополнительные конфиги можно класть в подключаемую директорию (/etc/mysql/conf.d/ или /etc/my.cnf.d/) отдельным файлом, что удобнее для внесения точечных изменений без редактирования основного файла настроек, который управляется пакетным менеджером.
mysqld --verbose --help | grep -A1 'Default options'
cp /etc/mysql/mysql.conf.d/mysqld.cnf /etc/mysql/mysql.conf.d/mysqld.cnf.bak
Перед любым изменением стоит сделать копию текущего файла — если новая настройка окажется ошибочной по синтаксису, служба MySQL просто не запустится после перезапуска, и наличие рабочей копии конфига позволяет мгновенно откатиться, а не разбираться в причине сбоя на работающем production-сервере под давлением времени.
mysqld --validate-config
systemctl restart mysql
systemctl status mysql
Многие параметры можно проверить на лету без перезапуска через команду SET GLOBAL прямо в клиенте MySQL — это удобно для экспериментов с конкретным значением под реальной нагрузкой без риска, что ошибочный синтаксис в файле конфигурации помешает службе запуститься. Но для того, чтобы изменение сохранилось после следующего перезапуска сервера, его всё равно нужно продублировать в my.cnf — SET GLOBAL меняет только текущее состояние работающего процесса в памяти.
innodb_buffer_pool_size — самая важная настройка
Буферный пул InnoDB — это область оперативной памяти, где MySQL хранит наиболее часто используемые данные и индексы таблиц, избегая обращения к диску на каждый запрос. Это без преувеличения самый влиятельный параметр во всей конфигурации MySQL: если рабочий набор данных сайта (те строки и индексы, к которым реально идут обращения) помещается в буферный пул целиком, подавляющее большинство запросов на чтение обслуживается из памяти, а не с диска.
[mysqld]
innodb_buffer_pool_size = 4G
Общее эмпирическое правило для сервера, где MySQL — основная и практически единственная нагрузка: выделять под буферный пул около 60-70% от общего объёма оперативной памяти сервера, оставляя остаток под операционную систему, сам процесс mysqld вне буферного пула и системные нужды. Если на том же сервере работает ещё и веб-приложение (например, WordPress с PHP-FPM на одном VPS с базой данных), долю стоит заметно снизить, чтобы не оставить недостаточно памяти для остальных процессов.
Проверить, насколько эффективно используется текущий размер буферного пула, можно через отношение попаданий к промахам — команда SHOW ENGINE INNODB STATUS выводит подробную статистику, включая Buffer pool hit rate. Значение заметно ниже 99% на активно работающем сайте обычно означает, что буферный пул слишком мал для реального объёма часто запрашиваемых данных, и его стоит увеличить, если позволяет доступная память сервера.
Увеличение buffer pool — это, пожалуй, единственная настройка MySQL, где почти невозможно "переборщить" в разумных пределах доступной памяти: чем больше рабочего набора данных помещается в память, тем меньше обращений к диску на каждый запрос.
Частое наблюдение в практике администрирования MySQL
max_connections: почему больше не значит быстрее
Параметр max_connections задаёт верхний предел числа одновременных подключений к серверу MySQL. Интуитивно кажется, что чем выше это значение, тем лучше сервер справится с всплеском посетителей, но у каждого открытого соединения есть своя цена в оперативной памяти — буферы под сортировку (sort_buffer_size), соединение с временными таблицами (tmp_table_size) и другие структуры выделяются на каждое соединение отдельно.
[mysqld]
max_connections = 150
wait_timeout = 120
При выставленном max_connections в несколько тысяч без учёта реальной доступной памяти сервер честно попытается обслужить такое количество одновременных подключений, если они действительно возникнут, — и результатом станет не более быстрая обработка запросов, а нехватка памяти под сами буферы соединений, своп и резкая деградация производительности всего сервера, вплоть до срабатывания OOM Killer операционной системы и аварийного завершения самого процесса mysqld.
Куда более надёжный подход к росту числа одновременных клиентов — connection pooling на стороне приложения: пул уже открытых соединений переиспользуется между запросами вместо открытия нового TCP-соединения и полной процедуры аутентификации на каждый отдельный запрос к базе данных. Большинство современных фреймворков и ORM поддерживают пул соединений из коробки, и разумная настройка пула на уровне приложения снижает реальную нагрузку на MySQL заметно эффективнее, чем простое повышение max_connections.
Параметр wait_timeout дополнительно ограничивает, сколько времени неактивное (не выполняющее запрос) соединение может оставаться открытым, прежде чем сервер его закроет, — это защищает от накопления забытых открытых соединений от приложений, которые открывают подключение к базе данных, но не закрывают его явно после использования.
Slow query log: как найти реальные, а не предполагаемые узкие места
Догадки о том, какой именно запрос замедляет сайт, часто оказываются неверными — реальные узкие места обнаруживаются только через измерение, и для этого в MySQL есть встроенный механизм slow query log, записывающий все запросы, выполнение которых превысило заданный порог времени.
[mysqld]
slow_query_log = 1
slow_query_log_file = /var/log/mysql/mysql-slow.log
long_query_time = 1
log_queries_not_using_indexes = 1
Параметр long_query_time задаёт порог в секундах, после которого запрос считается медленным и попадает в лог, — начинать разумно с 1 секунды для большинства сайтов, постепенно снижая порог по мере того, как самые заметные медленные запросы будут найдены и оптимизированы. Дополнительная опция log_queries_not_using_indexes фиксирует все запросы, не использующие ни один индекс, даже если они укладываются в лимит по времени, — это помогает найти потенциальные проблемы на растущих таблицах ещё до того, как они станут по-настоящему медленными.
mysqldumpslow -s t -t 10 /var/log/mysql/mysql-slow.logУтилита mysqldumpslow, поставляемая вместе с MySQL, группирует похожие запросы (с разными значениями параметров, но одинаковой структурой) и сортирует их по выбранному критерию — флаг -s t сортирует по суммарному затраченному времени, что обычно важнее, чем единичный самый медленный запрос: гораздо больнее сайту запрос, который выполняется по 200 мс, но вызывается тысячи раз в минуту, чем редкий запрос на 5 секунд раз в сутки. Для более глубокого и наглядного анализа стоит рассмотреть pt-query-digest из набора утилит Percona Toolkit — он даёт заметно более детальную разбивку с процентилями и группировкой по нормализованному тексту запроса.
EXPLAIN: как прочитать план выполнения запроса
Когда конкретный медленный запрос найден через slow log, следующий шаг — понять, почему он медленный, а не гадать и добавлять индексы наугад. Для этого перед запросом достаточно поставить ключевое слово EXPLAIN, и MySQL вместо выполнения запроса вернёт описание плана его выполнения.
EXPLAIN SELECT * FROM orders
WHERE customer_id = 42 AND status = 'paid'
ORDER BY created_at DESC;
В выводе EXPLAIN стоит в первую очередь смотреть на несколько ключевых столбцов. Столбец type показывает способ доступа к данным: значение ALL означает полное сканирование всей таблицы построчно — самый медленный вариант на таблице заметного размера, тогда как ref или range говорят об использовании индекса для сужения диапазона просматриваемых строк. Столбец key показывает, какой конкретно индекс реально был выбран оптимизатором запросов, а rows — примерную оценку числа строк, которые придётся просмотреть для получения результата.
Особое внимание стоит уделить столбцу Extra: значения вроде "Using filesystem" или "Using temporary" сигнализируют, что MySQL не смог обойтись существующими индексами для сортировки или группировки данных и создаёт временную структуру для дополнительной обработки результата — почти всегда это указывает на отсутствие подходящего составного индекса, покрывающего одновременно условия WHERE и порядок ORDER BY или GROUP BY в запросе.
CREATE INDEX idx_customer_status_created
ON orders (customer_id, status, created_at);
Добавление такого составного индекса позволяет MySQL находить нужные строки по customer_id и status без полного сканирования таблицы, а затем читать их сразу в нужном порядке благодаря created_at в конце индекса — избегая как полного сканирования, так и отдельного этапа сортировки после выборки данных.
Query cache: почему его больше нет и что использовать вместо него
В версиях MySQL до 5.7 существовал встроенный механизм query cache, кэширующий полный текстовый результат SELECT-запроса по точному тексту самого запроса — при повторном обращении с идентичным текстом MySQL мог вернуть готовый результат, вообще не выполняя запрос заново.
На практике этот механизм оказался проблематичным настолько, что был объявлен устаревшим в MySQL 5.7 и полностью удалён в MySQL 8.0. Главная причина — глобальная блокировка при инвалидации: любая операция записи (INSERT, UPDATE, DELETE) в таблицу немедленно сбрасывала все закэшированные результаты запросов, затрагивающих эту таблицу, а сама операция кэширования и инвалидации требовала блокировки, конкурирующей за ресурсы со всеми остальными запросами к серверу. На активно обновляемых таблицах query cache приносил больше накладных расходов на постоянную инвалидацию, чем пользы от редких попаданий в кэш.
Query cache MySQL — классический пример оптимизации, которая отлично работает на синтетических бенчмарках с редкими записями, но становится узким местом на реальной нагрузке с постоянными обновлениями данных.
Официальное обоснование удаления query cache в документации MySQL 8.0
Вместо него современная практика опирается на два независимых уровня. Первый — уже разобранный буферный пул InnoDB, который эффективно кэширует данные и индексы на уровне страниц базы данных без проблемы глобальной инвалидации при записи, поскольку работает на более низком уровне абстракции, чем текст конкретного SQL-запроса. Второй — кэширование результатов на уровне самого приложения через Redis или Memcached, где логика инвалидации находится под полным контролем разработчика и может быть куда более точечной, чем "сбросить всё при любой записи в таблицу" — например, инвалидировать только конкретный закэшированный объект, изменившийся в результате операции.
Такое разделение ответственности оказывается заметно более гибким на практике: буферный пул решает задачу быстрого доступа к данным на уровне СУБД, а прикладное кэширование через Redis решает задачу избежания повторного выполнения дорогих запросов целиком там, где это оправдано конкретной бизнес-логикой приложения, а не универсальным правилом уровня СУБД.
Другие параметры, о которых стоит знать
innodb_flush_log_at_trx_commit определяет, насколько строго MySQL синхронизирует лог транзакций с диском при каждом коммите. Значение 1 (по умолчанию) даёт полную гарантию сохранности данных даже при внезапном отключении питания, но ценой дополнительной операции синхронизации на каждую транзакцию; значение 2 заметно ускоряет запись ценой теоретической потери последней секунды транзакций при аварийном сбое всей операционной системы, а не только самого MySQL.
innodb_flush_log_at_trx_commit = 1
innodb_log_file_size = 512M
table_open_cache = 4000
innodb_log_file_size задаёт размер файлов лога транзакций InnoDB — слишком маленький размер приводит к более частым контрольным точкам (checkpoint) и связанной с ними дополнительной нагрузкой на диск, тогда как разумно увеличенный размер снижает частоту таких операций ценой более долгого восстановления после аварийного завершения работы сервера. table_open_cache определяет, сколько дескрипторов открытых таблиц MySQL держит в кэше одновременно — на базе данных с большим количеством таблиц (например, из-за партиционирования или множества независимых сайтов на одном сервере) слишком низкое значение приводит к постоянному открытию и закрытию файлов таблиц, что заметно на дисковой нагрузке.
Типичные ошибки тюнинга MySQL
Копирование чужого my.cnf из интернета с настройками, рассчитанными на сервер совершенно другого объёма памяти и профиля нагрузки, без пересчёта под конкретное железо — это может привести как к недоиспользованию доступных ресурсов, так и к превышению реального объёма RAM с последующим свопом или падением службы.
Изменение сразу нескольких параметров одновременно без измерения эффекта каждого по отдельности — при таком подходе невозможно понять, какое конкретно изменение дало улучшение (или, наоборот, ухудшение), что делает дальнейший тюнинг фактически случайным процессом.
Погоня за максимальным значением max_connections вместо решения реальной проблемы через connection pooling на стороне приложения или оптимизацию самих медленных запросов, которые и создают избыточное количество одновременных соединений в первую очередь.
Полное игнорирование slow query log и EXPLAIN в пользу интуитивных догадок о причине медленной работы сайта — в подавляющем большинстве случаев реальная причина замедления находится за считаные минуты анализа лога, тогда как гадание методом проб и ошибок может растянуться на недели без гарантированного результата.
Чек-лист настройки MySQL под реальную нагрузку
Шаг 1. Определите объём RAM, реально доступный под MySQL с учётом других процессов на сервере, и настройте innodb_buffer_pool_size на уровне 60-70% от этого объёма.
Шаг 2. Задайте разумный max_connections исходя из реального ожидаемого числа одновременных подключений, а не максимально возможного значения, и рассмотрите connection pooling на стороне приложения при росте нагрузки.
Шаг 3. Включите slow query log с порогом long_query_time около 1 секунды и дайте ему поработать под реальной нагрузкой хотя бы сутки перед анализом.
Шаг 4. Проанализируйте накопленный лог через mysqldumpslow или pt-query-digest и найдите запросы с наибольшим суммарным временем выполнения, а не только самые медленные единичные случаи.
Шаг 5. Для каждого найденного проблемного запроса выполните EXPLAIN и добавьте недостающие составные индексы под конкретное сочетание условий WHERE, ORDER BY и GROUP BY.
Шаг 6. Не полагайтесь на query cache — используйте буферный пул InnoDB и кэширование на уровне приложения через Redis там, где это оправдано конкретной бизнес-логикой.
Итог: несколько параметров решают большую часть проблем
Настройка MySQL под реальную нагрузку не требует изучения всех сотен доступных параметров — подавляющее большинство практического выигрыша в производительности даёт правильная настройка буферного пула InnoDB под доступную память сервера, разумный лимит соединений и системный поиск реальных узких мест через slow query log и EXPLAIN вместо интуитивных догадок.
Тюнинг базы данных — это не разовая настройка, а процесс: по мере роста проекта, изменения структуры данных и профиля нагрузки те же самые параметры стоит пересматривать заново, опираясь на актуальные метрики, а не на настройки, подобранные когда-то давно под другой объём данных. Если не уверены, какая конфигурация сервера и настройка MySQL подойдут вашему проекту — опишите задачу в заявке внизу страницы, поможем подобрать и настроить конфигурацию под конкретную нагрузку.
Общие принципы мониторинга сервера, включая метрики использования CPU, RAM и диска, которые полезно сопоставлять с показателями самой СУБД, разобраны в статье про мониторинг сервера — регулярное наблюдение за этими метриками позволяет заметить надвигающуюся проблему с производительностью базы данных задолго до того, как она станет заметна реальным посетителям сайта.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Где находится файл my.cnf на разных дистрибутивах Linux?
На Ubuntu и Debian основной файл обычно расположен в /etc/mysql/mysql.conf.d/mysqld.cnf, на CentOS и других RHEL-подобных системах — в /etc/my.cnf, при этом оба дистрибутива поддерживают дополнительные конфиги в директории /etc/mysql/conf.d/ или /etc/my.cnf.d/, которые подключаются автоматически и удобны для внесения изменений отдельным файлом, не трогая основной.
Как узнать, какие настройки сейчас реально применены к работающему серверу?
Командой SHOW VARIABLES LIKE 'имя_параметра' внутри MySQL-клиента — она покажет значение, с которым сервер работает прямо сейчас, что не всегда совпадает со значением в файле конфигурации, если параметр был изменён на лету через SET GLOBAL без сохранения в конфиг.
Сколько именно RAM выделять под innodb_buffer_pool_size?
Общее правило для сервера, где MySQL — основная нагрузка, — около 60-70% от общего объёма RAM; если на том же сервере работает ещё и веб-приложение или PHP-FPM, долю стоит снизить, оставив достаточно памяти под них, чтобы не спровоцировать своп или срабатывание OOM Killer.
Что произойдёт, если выставить max_connections слишком большим?
MySQL будет готов принять больше одновременных соединений, но каждое из них резервирует память под собственные буферы сортировки и соединений — при реальном одновременном подключении большого числа клиентов сервер может исчерпать доступную RAM и либо уйти в своп с резкой деградацией производительности, либо быть остановлен OOM Killer операционной системы.
Нужно ли включать query cache для ускорения повторяющихся запросов?
Нет — query cache признан устаревшим механизмом ещё в MySQL 5.7 и полностью удалён в MySQL 8.0 из-за принципиальной проблемы блокировок при инвалидации на каждую операцию записи в таблицу; вместо него стоит полагаться на буферный пул InnoDB и кэширование результатов запросов на уровне приложения через Redis или Memcached.
Как быстро найти самые медленные запросы на сайте?
Включить slow query log с разумным порогом long_query_time (например, 1 секунда) и через некоторое время работы под реальной нагрузкой проанализировать накопленный лог утилитой mysqldumpslow или более продвинутым pt-query-digest, которая сгруппирует похожие запросы и покажет самые затратные по суммарному времени, а не по единичным случаям.
Что означает "Using filesystem" или "Using temporary" в выводе EXPLAIN?
Это означает, что MySQL не может выполнить сортировку или группировку данных средствами существующих индексов и вынужден создавать временную таблицу и сортировать данные отдельным проходом — верный сигнал, что запросу не хватает подходящего составного индекса под конкретное сочетание условий WHERE, ORDER BY и GROUP BY.
Можно ли менять настройки MySQL без перезапуска службы?
Многие динамические параметры можно менять на лету командой SET GLOBAL без перезапуска, но для сохранения изменения после перезапуска сервера его всё равно нужно продублировать в файле конфигурации — а часть параметров (включая innodb_buffer_pool_size в старых версиях) требует полного перезапуска службы для применения нового значения.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.