Диагностика ошибок 502 и 504 в Nginx
Разбираем принципиальную разницу между Bad Gateway и Gateway Timeout, где искать причину каждой из них и почему бездумное увеличение таймаутов — не решение, а отсрочка проблемы.
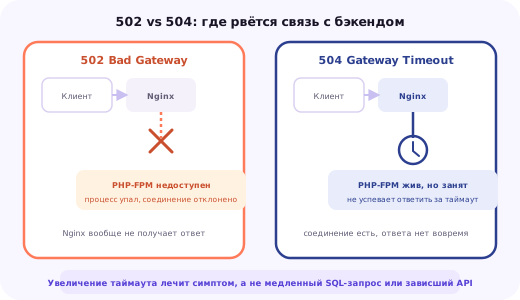
Bad Gateway и Gateway Timeout — это не одна и та же проблема
Nginx в подавляющем большинстве реальных сайтов работает не как единственный обработчик запроса, а как прокси перед другим процессом — PHP-FPM, Node.js-приложением, Python-сервисом на Gunicorn или другим бэкендом, к которому он обращается по внутреннему адресу через fastcgi_pass, proxy_pass или uwsgi_pass. Ошибки 502 и 504 — это оба сигнала о том, что именно на этом внутреннем участке что-то пошло не так, но сигналы принципиально разные по смыслу.
502 Bad Gateway означает, что Nginx вообще не смог установить рабочее взаимодействие с бэкендом или это взаимодействие было прервано до получения корректного ответа — бэкенд может быть полностью недоступен, отклонить соединение, или оборвать его на середине. С точки зрения Nginx это провал попытки связаться, а не долгое ожидание.
504 Gateway Timeout, напротив, означает, что соединение с бэкендом было успешно установлено и Nginx честно ждал ответа — но не дождался за отведённое время, заданное в его собственной конфигурации. Бэкенд в этот момент, скорее всего, жив и работает, просто выполняет запрос дольше, чем Nginx готов ждать.
Код ошибки говорит не о том, что сломалось на сайте вообще, а о том, что конкретно увидел Nginx на границе с бэкендом — дальнейшая диагностика всегда идёт от этой границы вглубь приложения, а не наоборот.
Практический принцип диагностики прокси-ошибок
Эта разница напрямую определяет, где искать причину: 502 почти всегда указывает на проблему с самим процессом-бэкендом (не запущен, упал, отказал в соединении), тогда как 504 указывает на проблему производительности внутри уже работающего запроса — медленный SQL-запрос, зависший внешний API, тяжёлые вычисления.
Где смотреть в первую очередь: логи Nginx
Первый источник информации при появлении любой из этих ошибок — error-лог самого Nginx, обычно расположенный в /var/log/nginx/error.log. Он не покажет причину сбоя внутри приложения, но точно укажет, к какому именно upstream шёл запрос и как именно тот не ответил — это отсекает половину версий сразу.
tail -f /var/log/nginx/error.logХарактерные записи для 502 выглядят как "connect() failed (111: Connection refused) while connecting to upstream" — это означает, что порт или сокет бэкенда закрыт, то есть процесс не запущен или слушает не тот адрес, который указан в конфигурации Nginx. Запись "upstream prematurely closed connection while reading response header from upstream" означает другое: соединение было принято, но оборвано до завершения ответа — уже симптом сбоя внутри самого процесса-бэкенда, а не его полного отсутствия.
Для 504 типичная запись — "upstream timed out (110: Connection timed out) while reading response header from upstream" с указанием конкретного upstream-адреса и URI запроса, который не уложился в таймаут, — эта строка сразу говорит, какой именно эндпоинт стоит проверять на стороне приложения в первую очередь.
Второй шаг: логи самого бэкенда
Лог Nginx показывает симптом, но не первопричину внутри приложения — за подробностями нужно идти в собственный лог бэкенда, который в связке с PHP работает через отдельный процесс PHP-FPM, подробно разобранный в статье о настройке этой связки.
Для PHP-FPM это error-лог самого пула (обычно /var/log/php8.3-fpm.log) — там будут видны фатальные ошибки PHP, превышение memory_limit, а также специфичное сообщение о достижении лимита pm.max_children, когда все рабочие процессы заняты и новым запросам просто некому ответить.
Для Node.js или Python-приложения, запущенного как отдельный процесс (часто под управлением systemd или pm2), нужно смотреть его собственный вывод — journalctl -u для systemd-сервиса или лог соответствующего процесс-менеджера — именно там будет виден стек вызовов необработанного исключения, приведшего к падению процесса.
Если сервис управляется через systemd, полезно сразу проверить и его текущий статус — состояние failed или частые перезапуски сами по себе уже говорят о нестабильности процесса ещё до чтения детального лога.
systemctl status php8.3-fpm
journalctl -u myapp.service --since "10 minutes ago"
Частые причины 502: бэкенд не отвечает
Самая простая причина — служба-бэкенд не запущена или упала после сбоя. Проверяется командой systemctl status с именем соответствующего сервиса, а лечится обычно перезапуском — но важно после перезапуска проверить лог на причину исходного падения, а не считать инцидент закрытым только потому, что сайт снова открылся.
Пул PHP-FPM исчерпал pm.max_children — все рабочие процессы заняты обработкой других запросов, и новые соединения от Nginx получают отказ вместо ответа. В логе PHP-FPM это видно по сообщению "server reached pm.max_children setting, consider raising it" — решение либо в увеличении лимита при наличии свободной памяти, либо в поиске и устранении причины, по которой процессы задерживаются дольше обычного (например, медленный внешний запрос внутри самого PHP-кода).
Несовпадение пути к unix-сокету между конфигурацией Nginx (fastcgi_pass) и конфигурацией пула PHP-FPM (listen) — типичная ошибка после обновления версии PHP, когда путь к сокету меняется (например, с php8.2-fpm.sock на php8.3-fpm.sock), а конфигурация Nginx не была обновлена вслед за этим.
Для Node.js или другого standalone-процесса частая причина — необработанное исключение, приводящее к аварийному завершению всего процесса целиком (в отличие от PHP-FPM, где падение одного запроса обычно не убивает весь пул воркеров) — здесь особенно важен process-менеджер вроде pm2 или systemd с Restart=on-failure, чтобы единичный сбой в коде не оставлял весь сайт полностью недоступным до ручного вмешательства.
Частые причины 504: бэкенд жив, но не успевает
Самая частая практическая причина — медленный SQL-запрос без нужного индекса, который на малых объёмах данных выполнялся мгновенно, а с ростом таблицы стал занимать секунды или десятки секунд. Диагностируется через slow query log базы данных или explain-анализ конкретного запроса — подробнее об устройстве и диагностике баз данных рассказано в отдельной статье сравнения MySQL и PostgreSQL.
Зависший внешний API — если приложение при обработке запроса дожидается ответа от стороннего сервиса (платёжного шлюза, службы доставки, внешнего API геолокации) без собственного таймаута на этот вызов, зависание чужого сервиса напрямую превращается в 504 у вашего сайта, даже если весь остальной код работает штатно.
Недостаточный proxy_read_timeout или fastcgi_read_timeout для объективно долгих операций — генерация большого отчёта, экспорт каталога товаров, обработка загруженного видео — такие операции по своей природе могут занимать больше времени, чем стандартный таймаут в 30–60 секунд, рассчитанный на обычные страницы сайта.
Нехватка ресурсов CPU на сервере в целом — если сервер перегружен другими процессами и физически не успевает выполнять вычисления в разумное время, любой, даже обычно быстрый запрос может начать превышать таймаут; здесь помогает базовый мониторинг нагрузки, который подробно разобран в отдельной статье базы знаний.
Блокировки на уровне базы данных — если один запрос держит длинную транзакцию с блокировкой строки или таблицы, все остальные запросы, которым нужна та же самая блокировка, вынужденно встают в очередь и ждут её освобождения; внешне это выглядит как массовая деградация скорости множества разных операций одновременно, хотя причина сосредоточена в одном-единственном зависшем запросе или незакрытой транзакции.
Кэш, переставший работать, а не просто отсутствовавший изначально — если страница обычно собирается за миллисекунды благодаря кэшированному результату в Redis или Memcached, а служба кэша по какой-то причине стала недоступна или переполнена, приложение резко переключается на полный пересчёт данных из базы для каждого запроса, и время ответа, привычно укладывавшееся в доли секунды, может вырасти на порядок именно в момент такого сбоя.
Почему просто увеличивать таймауты — плохая практика по умолчанию
Увеличение fastcgi_read_timeout или proxy_read_timeout — самое простое действие, доступное администратору, и потому самое соблазнительное. Но для большинства причин 504 оно не устраняет проблему, а лишь отодвигает момент её проявления и продлевает время, в течение которого посетитель сайта ждёт ответа, глядя на пустой экран браузера.
Для медленного SQL-запроса увеличенный таймаут означает, что вместо ошибки через 30 секунд пользователь получит ответ через 90 — формально сайт «не падает», но опыт использования остаётся плохим, а сама причина медленности (отсутствующий индекс, неоптимальный запрос) никуда не делась и будет только усугубляться с ростом объёма данных.
Таймаут — это защитный механизм от бесконечного ожидания, а не инструмент лечения медленного кода; увеличивать его стоит только тогда, когда операция объективно долгая по своей сути, а не когда она медленная из-за устранимой проблемы.
Практический принцип настройки таймаутов
Более того, слишком большой таймаут создаёт собственный риск: зависший процесс-воркер (PHP-FPM, Node.js) занимает слот в пуле обработки на всё время ожидания, и при накоплении нескольких таких зависших запросов пул исчерпывается быстрее, вызывая уже ошибку 502 у остальных, полностью здоровых запросов к тому же серверу.
Разумная стратегия — синхронизировать таймауты Nginx и бэкенда на уровне, достаточном для реально легитимных долгих операций проекта, но при этом отдельно расследовать и устранять причину медленности там, где она устранима, вместо того чтобы поднимать таймаут при каждом новом случае 504.
Настройка таймаутов там, где увеличение действительно оправдано
Для операций, которые объективно требуют больше времени по своей природе — например, отдельного эндпоинта экспорта данных или загрузки крупных файлов — таймаут стоит увеличивать точечно для конкретного location, а не глобально для всего сайта, чтобы не маскировать проблему на обычных, быстрых страницах.
location /export/ {
    fastcgi_pass unix:/run/php/php8.3-fpm.sock;
    fastcgi_read_timeout 300s;
    include fastcgi_params;
    fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name;
}
Соответствующий таймаут стоит выставить и на стороне самого PHP-FPM через request_terminate_timeout — если он окажется меньше, чем fastcgi_read_timeout в Nginx, PHP-FPM прервёт скрипт раньше, чем Nginx успеет засчитать это как собственный таймаут, что даст непредсказуемое поведение вместо понятной ошибки.
php_admin_value[request_terminate_timeout] = 300sДля внешних API-вызовов правильное место для таймаута — не в Nginx, а внутри самого кода приложения: HTTP-клиент, вызывающий сторонний сервис, должен иметь собственный явный таймаут заметно короче общего таймаута Nginx, чтобы приложение успело корректно обработать ситуацию «внешний сервис не ответил» и вернуть пользователю осмысленное сообщение, а не молча зависнуть до истечения общего лимита.
Практический пример: диагностика 502 после деплоя новой версии
Типичный сценарий: сразу после деплоя новой версии кода сайт начинает массово отдавать 502. Первый шаг — проверить статус сервиса-бэкенда, поскольку деплой мог включать обновление зависимостей, миграцию или изменение конфигурации, которое помешало сервису корректно перезапуститься.
systemctl status php8.3-fpm
tail -50 /var/log/php8.3-fpm.log
Если сервис в статусе failed, стоит посмотреть на само сообщение об ошибке при попытке запуска — часто это синтаксическая ошибка в php.ini или конфигурации пула, добавленная деплой-скриптом, либо несовместимость новой версии кода с расширением PHP, которое не было установлено на сервере вместе с обновлением.
Если же сервис в статусе active, но 502 продолжаются, вероятная причина — конфигурация Nginx указывает на путь к сокету или порт, изменившийся в новой версии деплой-скрипта, либо приложение стартовало, но не успело пройти внутреннюю инициализацию (подключение к базе данных, прогрев кэша) к моменту, когда Nginx уже начал направлять на него реальный трафик.
Мониторинг и раннее обнаружение вместо реакции по факту жалоб
Ожидание жалоб от посетителей сайта — самый медленный и болезненный способ узнать о появлении 502 или 504. Базовый внешний мониторинг доступности, регулярно проверяющий главную страницу и ключевые эндпоинты сайта, сообщит о проблеме за секунды, а не за то время, пока недовольный пользователь напишет в поддержку.
Отдельного внимания заслуживает мониторинг метрик самого PHP-FPM через встроенную страницу статуса пула — она показывает в реальном времени, насколько близко текущая нагрузка подошла к pm.max_children, что позволяет заметить приближающуюся проблему до того, как она превратится в реальные 502 у посетителей.
Для базы данных аналогичную роль играет slow query log и мониторинг числа активных соединений — рост длительности типичных запросов со временем часто предшествует появлению 504 на несколько дней или недель, давая запас времени на спокойную оптимизацию вместо аварийного исправления посреди рабочего дня.
Чек-лист диагностики 502 и 504
Шаг 1. Определите точный код ошибки и время её появления — 502 указывает на недоступность бэкенда, 504 на превышение времени ожидания уже установленного соединения.
Шаг 2. Проверьте error-лог Nginx на точную формулировку сообщения об ошибке и адрес upstream, к которому шёл неудачный запрос.
Шаг 3. Проверьте статус и собственный лог сервиса-бэкенда (PHP-FPM, Node.js, другой процесс) — именно там обычно находится первопричина, а не в самом Nginx.
Шаг 4. Для 502 проверьте: запущен ли сервис, совпадает ли путь к сокету или порту в обеих конфигурациях, не достигнут ли лимит pm.max_children.
Шаг 5. Для 504 проверьте: нет ли медленного SQL-запроса, зависшего внешнего API-вызова или недостаточного таймаута для объективно долгой операции.
Шаг 6. Увеличивайте таймауты точечно и только для операций, которые действительно долгие по своей природе — не как универсальное решение для любой 504.
Шаг 7. Настройте базовый мониторинг доступности и метрик пула бэкенда, чтобы узнавать о приближающейся проблеме раньше, чем о ней сообщат посетители сайта.
Итог: код ошибки — это подсказка, а не диагноз
Ошибки 502 и 504 указывают на разные по своей природе проблемы: 502 — на недоступность бэкенда, 504 — на его чрезмерную медлительность при живом соединении. Понимание этой разницы сразу сужает круг поиска и экономит время на диагностику, вместо того чтобы перебирать все возможные причины подряд.
В обоих случаях лог самого Nginx — только отправная точка, показывающая факт и место сбоя на границе с бэкендом; настоящая причина почти всегда находится глубже, в логах и метриках самого приложения, базы данных или внешнего сервиса, от которого зависит обработка запроса. Если диагностика подобных ошибок регулярно отнимает время, а не решается по понятному чек-листу, — оставьте заявку внизу страницы, поможем разобраться с конкретной конфигурацией сервера.
Постоянная настройка таймаутов и мониторинга ключевых метрик — не разовая задача, а часть текущего сопровождения растущего проекта: профиль нагрузки меняется со временем, и то, что было объективно быстрым запросом полгода назад, вполне может стать источником регулярных 504 сегодня без единой строчки изменений в коде, просто из-за роста объёма данных.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
В чём принципиальная разница между 502 и 504?
502 Bad Gateway означает, что Nginx вообще не смог получить ответ от бэкенда — соединение отклонено, оборвано или бэкенд недоступен; 504 Gateway Timeout означает, что соединение с бэкендом установлено успешно, но ответ не пришёл за отведённое время — бэкенд жив, но слишком медленный для конкретного запроса.
Куда смотреть в первую очередь при появлении 502 или 504?
Сначала в error-лог самого Nginx (обычно /var/log/nginx/error.log) — там будет указано, какой именно upstream не ответил и по какой причине; затем в лог самого бэкенда (PHP-FPM, Node.js, Python-приложения), поскольку Nginx видит только факт сбоя, а не его первопричину внутри приложения.
Поможет ли увеличение fastcgi_read_timeout или proxy_read_timeout решить проблему с 504?
Иногда да, если запрос действительно легитимно долгий (тяжёлый отчёт, импорт большого файла) и таймаут был занижен искусственно. Но если запрос виснет из-за медленного SQL-запроса без индекса или зависшего внешнего API, увеличение таймаута лишь отложит момент появления ошибки, не решая исходную причину медленности.
Может ли 502 появляться не из-за PHP-FPM, а из-за самого Nginx?
Да, хотя это реже: например, при исчерпании файловых дескрипторов на уровне операционной системы или ошибке в конфигурации proxy_pass, указывающей на неверный адрес или порт, Nginx тоже вернёт 502, даже если бэкенд физически исправен и просто не там, куда обращается Nginx.
Что означает сообщение "upstream prematurely closed connection" в логе Nginx?
Это означает, что бэкенд принял соединение, но оборвал его до отправки полного ответа — часто это происходит из-за превышения memory_limit в PHP, падения самого процесса-обработчика (например, из-за необработанного исключения) или достижения его собственного внутреннего таймаута раньше, чем истёк таймаут на стороне Nginx.
Может ли 504 быть вызвана самим Nginx, а не медленной базой данных или API?
Да, если сам proxy_read_timeout или fastcgi_read_timeout выставлен слишком низко для абсолютно нормального по своей природе запроса — например, для генерации большого PDF-отчёта, которая занимает 40 секунд, при таймауте в 30 секунд Nginx оборвёт вполне здоровый процесс раньше, чем он успеет закончить работу.
Как отличить перегрузку PHP-FPM от падения самого процесса PHP-FPM?
В логе PHP-FPM при перегрузке появляется характерное сообщение "server reached pm.max_children setting" — сервис жив, но все воркеры заняты; при полном падении процесса systemctl status покажет статус failed или inactive, а Nginx в этот момент будет получать ошибку соединения, а не таймаут ожидания.
Стоит ли настраивать автоматический перезапуск сервиса при сбое как постоянное решение проблемы 502?
Автоматический перезапуск через systemd (Restart=on-failure) — разумная страховка от единичных сбоев, но если сервис падает регулярно, это симптом более глубокой проблемы (утечка памяти, необработанное исключение, нехватка ресурсов), и постоянный перезапуск лишь маскирует её, не давая накопиться данным для диагностики первопричины.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.