Балансировка нагрузки: настройка upstream в Nginx
Как распределить трафик между несколькими серверами приложения средствами Nginx: синтаксис upstream, методы балансировки, отметка backend как down или backup и когда штатных возможностей уже недостаточно.
Какую проблему решает балансировка нагрузки
Пока сайт помещается на один сервер по ресурсам CPU, памяти и пропускной способности сети, вопрос балансировки не встаёт — весь трафик просто идёт на единственную машину. Проблема появляется в двух случаях: когда нагрузка вырастает настолько, что один сервер физически не справляется с потоком запросов, и когда важна отказоустойчивость — недопустимость полной остановки сайта при аварии одного-единственного сервера.
Вертикальное масштабирование (взять сервер помощнее) решает первую проблему временно и всегда упирается в физический потолок конкретной линейки оборудования, а вторую проблему не решает вообще — сколь угодно мощный единственный сервер остаётся единой точкой отказа: при его аварии или плановом обслуживании сайт становится полностью недоступен на всё время простоя.
Горизонтальное масштабирование — несколько одинаковых серверов приложения вместо одного, с балансировщиком нагрузки перед ними, распределяющим входящие запросы, — решает обе задачи одновременно: суммарная пропускная способность растёт с добавлением новых серверов, а отказ одного из них не останавливает сайт целиком, поскольку остальные продолжают обрабатывать трафик.
Балансировка нагрузки — это не про то, чтобы каждый отдельный запрос обрабатывался быстрее, а про то, чтобы система в целом выдерживала больше одновременных запросов и переживала отказ отдельной части инфраструктуры без полной остановки.
Общий принцип построения отказоустойчивых веб-сервисов
Nginx, изначально известный как веб-сервер и обратный прокси, умеет выполнять и роль балансировщика нагрузки между несколькими серверами приложения (backend) — эта статья разбирает синтаксис upstream-блока, встроенные методы распределения запросов, отметку серверов как недоступных или резервных, встроенные проверки здоровья и то, когда штатных возможностей открытой версии Nginx уже недостаточно.
Синтаксис upstream-блока
Базовая единица конфигурации балансировки в Nginx — блок upstream, объявляемый на верхнем уровне конфигурации (вне server-блока) и перечисляющий адреса серверов, между которыми нужно распределять запросы.
upstream backend_app {
    server 10.0.0.11:3000;
    server 10.0.0.12:3000;
    server 10.0.0.13:3000;
}

server {
    listen 80;
    server_name example.ru;

    location / {
        proxy_pass http://backend_app;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Имя upstream_backend (в примере — backend_app) используется в директиве proxy_pass точно так же, как обычный адрес сервера, — Nginx самостоятельно выбирает конкретный сервер из списка для каждого нового запроса согласно выбранному методу балансировки, полностью прозрачно для остальной части конфигурации.
Серверы в upstream-блоке могут быть указаны как по IP-адресу с портом, так и по unix-сокету — последнее актуально, если несколько экземпляров приложения (например, несколько процессов PHP-FPM или Node.js) запущены на одном физическом сервере, но в отдельных процессах, и балансировка нужна между ними, а не между разными физическими машинами.
Round-robin: метод по умолчанию
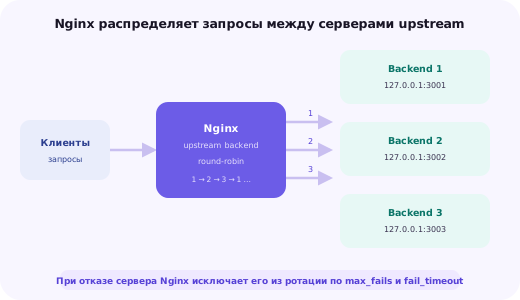
Если в upstream-блоке явно не указан другой метод балансировки, Nginx использует round-robin — простое поочерёдное распределение запросов по кругу: первый запрос на первый сервер, второй на второй, третий на третий, четвёртый снова на первый и так далее.
Round-robin прост и предсказуем, но не учитывает текущую фактическую загруженность каждого сервера — если один из запросов оказался существенно тяжелее остальных и занял сервер надолго, round-robin всё равно продолжит направлять на него новые запросы по расписанию своей очереди, не заглядывая в то, готов ли этот сервер их принять.
upstream backend_app {
    server 10.0.0.11:3000 weight=3;
    server 10.0.0.12:3000 weight=1;
}
Параметр weight позволяет скорректировать чистое равномерное распределение под серверы разной мощности — например, если один сервер приложения физически мощнее другого, весовой коэффициент направит на него пропорционально больше запросов, оставаясь в рамках той же простой круговой модели.
least_conn: когда запросы сильно различаются по стоимости
Метод least_conn направляет каждый новый запрос на тот сервер, у которого в данный момент меньше всего активных, ещё не завершённых соединений, — в отличие от round-robin, он реально учитывает текущее состояние загрузки, а не просто следует заранее заданному порядку.
upstream backend_app {
    least_conn;
    server 10.0.0.11:3000;
    server 10.0.0.12:3000;
}
Это особенно полезно, когда часть запросов объективно быстрая (простые страницы, статические данные из кэша), а часть — тяжёлая по времени обработки (сложный поиск, формирование отчёта, экспорт данных): round-robin в такой ситуации может направить новый запрос на сервер, уже занятый тяжёлой задачей, просто потому, что подошла его очередь по кругу, тогда как least_conn отправит его туда, где сервер сейчас реально свободнее.
Для типичного сайта с примерно однородными по стоимости обработки запросами разница между round-robin и least_conn на практике почти не ощущается — метод стоит менять осознанно, когда есть конкретное наблюдение о неравномерности длительности запросов, а не менять его заранее «на всякий случай» без реальных оснований.
ip_hash: привязка клиента к одному серверу
Метод ip_hash вычисляет хеш от IP-адреса клиента и на основе этого хеша стабильно направляет все запросы одного и того же клиента на один и тот же сервер из списка — до тех пор, пока состав серверов в upstream-блоке не меняется.
upstream backend_app {
    ip_hash;
    server 10.0.0.11:3000;
    server 10.0.0.12:3000;
}
Такая привязка нужна, когда приложение хранит состояние сессии пользователя локально в памяти конкретного сервера (например, стандартные PHP-сессии по умолчанию хранятся в файлах на диске того сервера, где они были созданы) — без ip_hash пользователь, чей следующий запрос round-robin направит на другой сервер, внезапно окажется разлогинен или потеряет данные корзины интернет-магазина, поскольку новый сервер ничего не знает о его сессии.
Более архитектурно правильное решение той же проблемы — сделать приложение по-настоящему stateless, вынеся хранение сессий в общее для всех серверов место, например Redis, — тогда любой сервер сможет обработать запрос любого пользователя одинаково корректно, и привязка через ip_hash вообще перестаёт быть нужна. ip_hash в этом смысле — практичный быстрый обходной путь для уже существующего приложения, а не рекомендуемая цель для нового проекта.
У ip_hash есть и практический недостаток: пользователи за одним и тем же корпоративным NAT или мобильным оператором с общим внешним IP-адресом для множества разных людей все окажутся привязаны к одному и тому же серверу, что при определённой концентрации таких пользователей может создать неравномерную нагрузку, несмотря на формально работающую балансировку.
Отметка сервера как down или backup
Иногда нужно временно вывести конкретный сервер из ротации — например, для планового обслуживания или обновления — не удаляя его полностью из конфигурации. Параметр down в описании сервера делает именно это: Nginx перестаёт направлять на него новые запросы, но сам сервер остаётся в конфигурации и может быть возвращён обратно простым удалением этого параметра.
upstream backend_app {
    server 10.0.0.11:3000;
    server 10.0.0.12:3000 down;
    server 10.0.0.13:3000;
}
Параметр backup решает другую задачу — не исключение, а понижение приоритета: сервер с этим параметром не получает запросов, пока хотя бы один из основных серверов работает, и включается в ротацию автоматически, только когда все обычные серверы становятся недоступны.
upstream backend_app {
    server 10.0.0.11:3000;
    server 10.0.0.12:3000;
    server 10.0.0.99:3000 backup;
}
Резервный сервер часто имеет меньшую мощность, чем основные, — его задача не полноценно заменить пропускную способность всей группы, а сохранить сайт хотя бы частично работоспособным на время устранения проблемы с основными серверами, что предпочтительнее полной недоступности сайта.
Пассивные проверки здоровья: max_fails и fail_timeout
Открытая версия Nginx не отправляет отдельных служебных запросов для проверки состояния серверов в upstream — вместо этого она использует пассивный механизм, узнающий о проблеме по факту неудачи реального запроса от настоящего пользователя.
upstream backend_app {
    server 10.0.0.11:3000 max_fails=3 fail_timeout=30s;
    server 10.0.0.12:3000 max_fails=3 fail_timeout=30s;
}
При max_fails=3 и fail_timeout=30s Nginx после трёх неудачных попыток обратиться к серверу подряд в течение 30-секундного окна временно помечает его как недоступный и не направляет туда новые запросы в течение следующих 30 секунд, после чего пробует снова — если сервер к этому моменту восстановился, он автоматически возвращается в ротацию без вмешательства администратора.
Важная особенность именно пассивной проверки — о проблеме с сервером Nginx узнаёт только через реальный неудачный запрос настоящего посетителя сайта, то есть первые несколько пользователей, чей запрос попал на упавший сервер до срабатывания max_fails, всё же получат ошибку, прежде чем Nginx исключит проблемный сервер из ротации.
Активные health-checks: возможность Nginx Plus
Более совершенный подход — активная проверка здоровья: Nginx сам, независимо от реального пользовательского трафика, с заданным интервалом отправляет служебные запросы на выделенный health-check эндпоинт каждого сервера и заранее узнаёт о проблеме до того, как её встретит реальный пользователь.
Эта возможность, однако, доступна только в платной версии Nginx Plus, а не в открытой (open source) сборке Nginx, которая используется в подавляющем большинстве случаев по умолчанию, — открытая версия ограничена именно пассивным механизмом max_fails/fail_timeout, описанным выше.
Частичной заменой активных health-checks для открытой версии Nginx служат внешние решения — отдельный скрипт или система мониторинга, которая сама проверяет состояние каждого backend-сервера и, обнаружив проблему, автоматически меняет конфигурацию Nginx (например, добавляя параметр down проблемному серверу) с последующей мягкой перезагрузкой через nginx -s reload — рабочий, но заметно более сложный в сопровождении путь по сравнению со встроенной функциональностью Nginx Plus.
Когда DIY-балансировка на Nginx уже не лучший выбор
Nginx как балансировщик отлично справляется с распределением трафика между несколькими серверами приложения в пределах одного дата-центра, где сетевая задержка между балансировщиком и backend-серверами минимальна и предсказуема.
Ситуация меняется, если серверы приложения физически расположены в разных дата-центрах или разных географических регионах — здесь встаёт вопрос маршрутизации пользователя к ближайшему по географии серверу и обработки не просто отказа отдельного сервера, а полной недоступности целого дата-центра, для чего одного Nginx-инстанса на переднем крае уже недостаточно.
Аналогично, при необходимости терминировать SSL на большом объёме трафика с автоматическим масштабированием мощности самого балансировщика под нагрузку, встроенной защитой от DDoS-атак на уровне сети, или при желании управлять балансировкой через отдельный API без ручного редактирования конфигурационных файлов на каждом изменении — специализированный продукт балансировки нагрузки решает эти задачи из коробки, тогда как повторение той же функциональности через самостоятельно администрируемый Nginx потребовало бы значительных дополнительных усилий по разработке и сопровождению.
Практический ориентир: пока речь идёт о нескольких серверах приложения в одном дата-центре с относительно предсказуемой нагрузкой, самостоятельно настроенный Nginx-балансировщик — рабочее и экономичное решение. Когда появляется требование к географическому распределению, автоматическому масштабированию самого балансировщика или расширенным встроенным health-checks без покупки Nginx Plus — стоит присмотреться к отдельному продукту балансировки нагрузки.
Практический пример: балансировка перед несколькими PHP-FPM пулами
Балансировка не обязательно означает несколько физических серверов — тот же принцип применим и к нескольким пулам PHP-FPM на одном мощном сервере, что может быть полезно для изоляции разных типов нагрузки друг от друга внутри одной машины.
upstream php_pool {
    least_conn;
    server unix:/run/php/pool-web.sock;
    server unix:/run/php/pool-web-2.sock;
}

server {
    location ~ \.php$ {
        fastcgi_pass php_pool;
        include fastcgi_params;
        fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name;
    }
}
Такая схема реже встречается на практике по сравнению с балансировкой между отдельными физическими серверами, но иллюстрирует общий принцип: upstream-блок Nginx работает с любыми адресами бэкенда одинаково, будь то удалённый IP, локальный порт или unix-сокет, и логика распределения запросов не зависит от того, где физически находится каждый из вариантов.
Чек-лист настройки балансировки в Nginx
Шаг 1. Убедитесь, что приложение действительно готово к горизонтальному масштабированию — сессии и другое состояние либо не хранятся локально на сервере, либо вынесены в общее хранилище вроде Redis, либо используется ip_hash как временное решение.
Шаг 2. Опишите upstream-блок со всеми серверами приложения и выберите метод балансировки — round-robin по умолчанию, least_conn при заметной разнице в стоимости обработки запросов, ip_hash только при реальной необходимости привязки к серверу.
Шаг 3. Настройте пассивные проверки через max_fails и fail_timeout под реальный профиль надёжности ваших серверов приложения.
Шаг 4. Предусмотрите резервный сервер через backup для критичных проектов, где полная недоступность сайта при отказе всех основных серверов недопустима даже временно.
Шаг 5. Проверьте конфигурацию командой nginx -t и примените изменения через мягкую перезагрузку nginx -s reload, не разрывая уже установленные соединения.
Шаг 6. Настройте мониторинг доступности каждого backend-сервера отдельно от общего мониторинга сайта, чтобы отслеживать реальную частоту срабатывания пассивных проверок здоровья.
Шаг 7. При росте требований к географическому распределению или расширенным health-checks оцените переход на специализированный продукт балансировки нагрузки вместо дальнейшего усложнения самостоятельной конфигурации Nginx.
Итог: встроенной балансировки Nginx достаточно для большинства проектов
Nginx закрывает задачу распределения нагрузки между несколькими серверами приложения без установки дополнительного специализированного софта — синтаксис upstream-блока прост, встроенные методы балансировки покрывают подавляющее большинство практических сценариев, а пассивные проверки здоровья, пусть и не такие быстрые, как активные из Nginx Plus, дают рабочий уровень автоматического исключения отказавших серверов из ротации.
Ключевое решение при настройке — выбрать метод балансировки осознанно, исходя из реального характера нагрузки конкретного проекта, а не по умолчанию: round-robin для однородных запросов, least_conn при заметной неравномерности их стоимости, ip_hash только как временная мера для приложения, ещё не готового к полностью stateless-архитектуре. Если конфигурация балансировки для конкретной инфраструктуры вызывает вопросы — оставьте заявку внизу страницы, поможем настроить upstream под реальный профиль нагрузки вашего проекта.
Переход от самостоятельно настроенного Nginx к специализированному продукту балансировки нагрузки — не признание неудачи DIY-подхода, а естественный следующий шаг, когда масштаб и требования проекта (география, объём трафика, встроенные активные проверки) перерастают возможности одного открытого Nginx-инстанса на переднем крае инфраструктуры.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Зачем нужна балансировка нагрузки, если можно просто взять более мощный сервер?
Вертикальное масштабирование (более мощный сервер) всегда упирается в физический потолок и создаёт единую точку отказа — при падении единственного сервера сайт становится полностью недоступен; горизонтальное масштабирование через несколько серверов и балансировщик распределяет и нагрузку, и риск отказа между несколькими независимыми машинами.
Какой метод балансировки в Nginx выбран по умолчанию?
Round-robin — поочерёдное распределение запросов между всеми серверами в upstream-блоке по кругу, без учёта их текущей загруженности; он не требует явного указания и применяется, если в блоке upstream не задан другой метод.
Когда стоит использовать least_conn вместо round-robin?
Когда запросы существенно различаются по стоимости обработки — например, часть запросов быстрые (отдача статики или простых страниц), а часть тяжёлые (генерация отчёта, сложный поиск); round-robin в этом случае может направить новый запрос на уже перегруженный тяжёлыми задачами сервер просто потому, что подошла его очередь, тогда как least_conn отправит его туда, где сейчас меньше всего активных соединений.
Зачем нужен ip_hash, если можно вынести сессии в общее хранилище?
ip_hash — способ получить привязку клиента к одному серверу без изменения кода приложения, что полезно как временное решение или для legacy-проектов, где вынос сессий в Redis или базу данных сам по себе требует доработки кода; для нового проекта архитектурно правильнее сделать приложение stateless и не полагаться на привязку к конкретному серверу вообще.
Что произойдёт, если один из серверов в upstream перестанет отвечать?
При включённых по умолчанию пассивных проверках Nginx после нескольких неудачных попыток подряд (задаётся max_fails) на протяжении заданного времени (fail_timeout) временно исключит этот сервер из ротации и будет направлять запросы только на оставшиеся исправные серверы, периодически пробуя вернуть проблемный сервер обратно.
Чем активные health-checks отличаются от пассивных и доступны ли они в бесплатном Nginx?
Пассивная проверка (доступна в открытой версии Nginx) узнаёт о проблеме постфактум — по факту неудачи реального запроса пользователя; активная проверка отправляет служебные запросы на выделенный health-check эндпоинт с заданным интервалом независимо от реального трафика, обнаруживая проблему до того, как её встретит живой пользователь, — но эта возможность доступна только в платной версии Nginx Plus, а не в открытой сборке.
Можно ли балансировать между серверами в разных дата-центрах через обычный Nginx?
Технически можно указать в upstream-блоке серверы с любыми доступными IP-адресами, включая находящиеся в другом дата-центре, но растущая при этом сетевая задержка между Nginx-балансировщиком и удалённым сервером, а также отсутствие вменяемых механизмов маршрутизации по географии делают этот сценарий поводом присмотреться к специализированному решению балансировки, а не к DIY-конфигурации Nginx.
В чём практическая разница между down и backup для сервера в upstream?
down полностью исключает сервер из ротации до ручного изменения конфигурации — используется для планового вывода сервера на обслуживание; backup, напротив, держит сервер в резерве и включает его в работу автоматически, только когда все основные серверы становятся недоступны, — то есть это не выключение, а понижение приоритета.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.