ClickHouse: для чего нужен и как развернуть на VPS
Что такое ClickHouse как колоночная OLAP-база данных, чем она принципиально отличается от строчных MySQL и PostgreSQL, установка на VPS, создание таблицы на движке MergeTree и honest-разбор, когда ClickHouse оправдан, а когда избыточен.
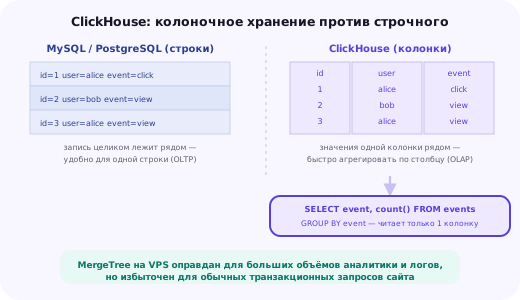
Колоночное хранение против строчного: в чём разница на практике
MySQL и PostgreSQL — классические строчные (row-oriented) СУБД: данные каждой строки таблицы физически хранятся на диске рядом друг с другом, что делает операции над целой строкой — вставку новой записи, обновление конкретного поля, выборку всех столбцов одной записи по первичному ключу — быстрыми и эффективными. Это идеально подходит для типичной транзакционной (OLTP) нагрузки веб-приложения: пользователь регистрируется, оформляет заказ, обновляет профиль — каждая такая операция затрагивает одну или немного строк целиком.
ClickHouse устроен принципиально иначе — это колоночная (column-oriented) СУБД, где данные каждого столбца хранятся отдельно от других столбцов, физически смежно друг с другом по всем строкам таблицы. Это меняет всё: запрос, агрегирующий значения одного конкретного столбца по миллионам строк (например, сумма выручки по дням за последний год), в колоночном хранилище читает с диска только данные этого одного нужного столбца, полностью пропуская остальные, тогда как строчная СУБД в том же сценарии вынуждена прочитать с диска все столбцы каждой строки, даже если реально нужен только один из них.
Колоночное хранение — это не просто другой способ разложить те же данные на диске, а фундаментально другой набор компромиссов: то, что дёшево для аналитики, дорого для транзакций, и наоборот.
Принцип проектирования OLAP-систем
Обратная сторона этой оптимизации — операции, естественные для строчной СУБД, становятся дорогими для колоночной: вставка одной строки требует записи в несколько разных физических мест на диске (по одному на каждый столбец), а обновление или удаление отдельной записи — фоновая, не мгновенная операция. Именно поэтому ClickHouse не заменяет MySQL или PostgreSQL для транзакционной нагрузки, а решает принципиально другой класс задач.
Типичные сценарии применения
ClickHouse проектировался как OLAP-система (Online Analytical Processing) — предназначенная для быстрого выполнения сложных аналитических запросов над большими объёмами данных, а не для обслуживания множества мелких транзакций одновременно. Наиболее типичные сценарии применения группируются вокруг данных, которые в основном пишутся один раз и затем многократно читаются в различных аналитических разрезах, но почти никогда не изменяются точечно после записи.
Классические примеры: аналитика веб- и мобильных приложений (события пользователей — просмотры страниц, клики, конверсии — с последующим построением воронок и когортного анализа); хранение и агрегация логов приложений и инфраструктуры в больших объёмах с быстрым построением метрик по времени; трекинг событий в реальном времени (IoT-телеметрия, метрики мониторинга); финансовая и торговая аналитика с агрегацией по времени и множеству измерений одновременно.
Общая черта всех этих сценариев — данные поступают потоком (часто большими пачками), запросы к ним преимущественно аналитические (агрегации, группировки, подсчёт по временным интервалам), а не точечные выборки одной записи по идентификатору, и объём данных обычно значительно больше того, с чем комфортно работает классическая OLTP-база без специальной подготовки в виде отдельных материализованных представлений или таблиц-агрегатов.
Установка ClickHouse на VPS
Официальный способ установки на Debian/Ubuntu — через APT-репозиторий проекта, что даёт возможность получать обновления стандартным способом и не требует ручной сборки из исходников.
curl -fsSL 'https://packages.clickhouse.com/rpm/lts/repodata/repomd.xml.key' | sudo gpg --dearmor -o /usr/share/keyrings/clickhouse-keyring.gpg
echo "deb [signed-by=/usr/share/keyrings/clickhouse-keyring.gpg] https://packages.clickhouse.com/deb stable main" | sudo tee /etc/apt/sources.list.d/clickhouse.list
sudo apt update
sudo apt install -y clickhouse-server clickhouse-clientsudo systemctl enable --now clickhouse-server
sudo clickhouse-clientВ процессе установки пакет clickhouse-server предложит задать пароль для пользователя default, что стоит сделать явно, а не оставлять пустым, даже если сервер планируется использовать только с локального доступа, — по умолчанию сервер слушает на 127.0.0.1 без внешнего доступа, но привычка не оставлять пустой пароль оправдывает себя при любых последующих изменениях конфигурации сети.
Для реальной эксплуатации на VPS стоит сразу решить вопрос выделенного диска или отдельного раздела под директорию данных ClickHouse (/var/lib/clickhouse по умолчанию) — колоночное хранилище при активной записи создаёт заметную нагрузку на диск в процессе фоновых операций слияния (merge) частей таблицы, и это стоит учитывать при выборе конфигурации VPS, отдавая предпочтение SSD, а не HDD.
Создание первой таблицы на движке MergeTree
MergeTree — базовое и наиболее часто используемое семейство движков таблиц в ClickHouse. Название отражает внутренний механизм: данные записываются частями (parts), которые периодически фоново объединяются (merge) в более крупные, что обеспечивает эффективное хранение и быстрое чтение отсортированных по заданному ключу данных.
CREATE TABLE events (
    event_date Date,
    event_time DateTime,
    user_id UInt64,
    event_type LowCardinality(String),
    value Float64
)
ENGINE = MergeTree()
PARTITION BY toYYYYMM(event_date)
ORDER BY (event_type, user_id, event_time)
Директива ORDER BY определяет ключ сортировки, по которому данные физически хранятся на диске — это одно из самых важных решений при проектировании таблицы, поскольку запросы, фильтрующие или группирующие по столбцам из начала ключа сортировки, выполняются заметно быстрее за счёт возможности пропускать целые блоки данных без чтения (механизм, аналогичный индексу, но встроенный в саму физическую организацию хранения). PARTITION BY, в свою очередь, разбивает таблицу на логические партиции (в примере — по месяцам), что упрощает последующее удаление устаревших данных целыми партициями без дорогостоящего построчного DELETE.
INSERT INTO events (event_date, event_time, user_id, event_type, value)
VALUES ('2026-11-11', '2026-11-11 14:22:00', 1001, 'page_view', 1.0);

SELECT event_type, count() AS cnt, sum(value) AS total
FROM events
WHERE event_date >= '2026-11-01'
GROUP BY event_type
ORDER BY cnt DESC;
Тип LowCardinality(String) в примере — практическая оптимизация ClickHouse для столбцов с относительно небольшим числом уникальных значений (типы событий, категории, страны): вместо хранения полной строки для каждой записи ClickHouse строит внутренний словарь уникальных значений и хранит компактные ссылки на них, что заметно экономит место и ускоряет запросы по таким столбцам.
Массовая вставка данных: пакетами, а не по одной строке
Одна из практических особенностей ClickHouse, о которую регулярно спотыкаются новички, — вставка отдельными, единичными INSERT-запросами крайне неэффективна и не рекомендуется для реальной нагрузки, в отличие от типичной практики в OLTP-базах, где вставка по одной строке — обычное дело.
Причина в том, что каждая вставка создаёт отдельную часть данных (data part) на диске, и при частых мелких вставках количество таких частей растёт быстрее, чем фоновый процесс слияния успевает их объединять, что в конечном счёте деградирует производительность как записи, так и чтения, а при достаточно большом накоплении несведённых частей ClickHouse может начать явно отклонять новые вставки до завершения слияния.
INSERT INTO events (event_date, event_time, user_id, event_type, value) VALUES
    ('2026-11-11', '2026-11-11 14:22:00', 1001, 'page_view', 1.0),
    ('2026-11-11', '2026-11-11 14:22:05', 1002, 'click', 1.0),
    ('2026-11-11', '2026-11-11 14:22:11', 1001, 'purchase', 49.90);
    -- ... и так далее, пачкой из тысяч строк за один запрос
Практическая рекомендация — буферизовать события на стороне приложения или через промежуточную очередь и отправлять в ClickHouse пачками из тысяч или десятков тысяч строк за один INSERT, либо использовать встроенный движок Buffer, накапливающий данные в памяти перед периодическим сбросом в основную таблицу — оба подхода на порядок снижают число создаваемых частей данных по сравнению с построчной вставкой.
Если источник данных — не собственное приложение, а внешняя система логирования или очередь сообщений вроде Kafka, для регулярной пакетной загрузки удобно использовать встроенные табличные движки-коннекторы ClickHouse (например, движок Kafka) или простой периодический скрипт, экспортирующий накопленные за интервал данные одним запросом — в обоих случаях цель одна: свести количество отдельных операций записи к разумному минимуму, оставляя сам объём передаваемых за один раз данных достаточно большим.
Когда ClickHouse — правильный инструмент
ClickHouse оправдан, когда объём данных для анализа уже достаточно велик (речь обычно о десятках миллионов строк и больше), запросы преимущественно аналитические — агрегации, группировки, подсчёты по большим временным диапазонам — и существующая строчная СУБД начинает заметно проседать именно на таких запросах, тогда как обычные транзакционные операции продолжают работать нормально.
Характерный сигнал, что пора рассмотреть ClickHouse, — аналитические отчёты или дашборды, построенные прямым SQL-запросом к продакшен-базе MySQL или PostgreSQL, начинают заметно замедлять саму базу для основного приложения, конкурируя за ресурсы с обычной транзакционной нагрузкой. В этой ситуации разумный паттерн — не заменять основную базу, а вынести именно аналитическую нагрузку в отдельный ClickHouse, куда данные попадают через периодическую выгрузку или потоковую репликацию, оставляя основную базу обслуживать только транзакционные операции приложения.
Мониторинг состояния сервера через системные таблицы
ClickHouse хранит подробную информацию о своей собственной работе в системной базе данных system, доступной для обычных SQL-запросов так же, как и любая пользовательская таблица — это удобно для повседневного мониторинга без необходимости во внешних инструментах на начальном этапе эксплуатации на VPS.
SELECT query, elapsed, memory_usage
FROM system.processes
ORDER BY elapsed DESC
LIMIT 10;
Таблица system.parts особенно полезна для диагностики упомянутой ранее проблемы избыточного числа несведённых частей данных при частых мелких вставках — большое количество активных частей для одной таблицы (значение active = 1) сигнализирует, что фоновый процесс слияния не успевает за темпом вставки, и стоит пересмотреть паттерн записи в сторону более крупных пакетных вставок.
SELECT table, count() AS parts_count
FROM system.parts
WHERE active
GROUP BY table
ORDER BY parts_count DESC;
Для продакшен-эксплуатации на VPS системные таблицы стоит выгружать во внешнюю систему мониторинга (Prometheus через встроенный эндпоинт /metrics или Grafana напрямую через ClickHouse как источник данных), чтобы отслеживать динамику потребления памяти, диска и числа запросов во времени, а не проверять состояние вручную SQL-запросом каждый раз, когда возникает подозрение на проблему.
Материализованные представления: предвычисленные агрегаты на лету
Отдельная мощная возможность ClickHouse — материализованные представления (materialized view), позволяющие автоматически пересчитывать и сохранять агрегированные данные в момент каждой вставки в исходную таблицу, а не заново пересчитывать агрегат при каждом обращении к нему. Это принципиально отличается от классического представления в строчных СУБД, которое обычно является просто сохранённым запросом, выполняемым заново при каждом обращении.
CREATE MATERIALIZED VIEW events_daily_mv
ENGINE = SummingMergeTree()
PARTITION BY toYYYYMM(event_date)
ORDER BY (event_type, event_date)
AS SELECT
    event_date,
    event_type,
    count() AS events_count,
    sum(value) AS total_value
FROM events
GROUP BY event_date, event_type;
При такой конфигурации каждая новая вставка в исходную таблицу events автоматически порождает соответствующую агрегированную запись в events_daily_mv через движок SummingMergeTree, который в фоне суммирует значения для одинаковых ключей сортировки. В результате запрос к уже агрегированной таблице events_daily_mv выполняется на порядки быстрее, чем аналогичная агрегация по всей исходной таблице событий каждый раз заново, поскольку объём данных для сканирования кардинально меньше.
Материализованные представления особенно ценны для дашбордов и отчётов, обращающихся к одним и тем же агрегатам многократно в течение дня — вместо повторного пересчёта суммы или количества по миллионам исходных строк при каждом открытии дашборда, запрос читает уже готовую, заранее свёрнутую агрегированную таблицу, которая обновляется постепенно, малыми порциями, по мере поступления новых исходных данных, а не при обращении.
Стоит помнить, что материализованное представление в ClickHouse — это не автоматическая индексация уже существующих данных, а триггер, срабатывающий только на новые вставки: если создать материализованное представление уже после того, как в исходную таблицу были загружены исторические данные, эти прошлые записи в представление не попадут автоматически, и для их учёта потребуется отдельно выполнить разовую вставку через INSERT INTO ... SELECT из исходной таблицы в представление задним числом.
Когда ClickHouse избыточен
Для проекта с небольшим объёмом данных (тысячи или десятки тысяч строк, укладывающиеся в обычные индексы MySQL или PostgreSQL без проблем с производительностью) внедрение отдельной колоночной СУБД добавляет ощутимую операционную сложность — ещё один сервис для установки, мониторинга, резервного копирования и обновления — без реального выигрыша, который окупил бы эти издержки.
Также ClickHouse не подходит как основное хранилище данных для типичного веб-приложения с частыми точечными обновлениями и удалениями отдельных записей: интернет-магазин, где статус заказа регулярно меняется, или CMS с частым редактированием контента, гораздо естественнее ложатся на строчную СУБД, где UPDATE и DELETE — штатные, быстрые и недорогие операции, а не фоновые тяжёлые процессы, какими они являются в ClickHouse.
Ориентир для принятия решения простой: если задача формулируется как «нужно быстро находить, изменять или удалять конкретную запись по идентификатору» — это классический сценарий для MySQL или PostgreSQL; если задача формулируется как «нужно быстро посчитать агрегат по миллионам записей за произвольный период» — это сценарий, для которого проектировался ClickHouse. Смешение этих сценариев в одной СУБД возможно, но обычно не даёт хорошего результата ни для одного из них.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Можно ли заменить MySQL или PostgreSQL на ClickHouse для обычного веб-приложения?
Как правило нет — ClickHouse оптимизирован под аналитические запросы, агрегирующие большие объёмы данных, а не под транзакционную нагрузку типичного веб-приложения с частыми одиночными вставками, обновлениями и выборками по первичному ключу, для которой строчные СУБД остаются заметно более подходящим и удобным выбором.
Поддерживает ли ClickHouse обновление и удаление отдельных строк так же легко, как MySQL?
Нет, обновления и удаления в ClickHouse — это тяжёлые, асинхронные операции (ALTER TABLE UPDATE/DELETE), выполняющиеся фоново и не рассчитанные на частое использование в духе обычного UPDATE в OLTP-базе; ClickHouse проектировался в первую очередь под сценарий «данные пишутся один раз и в основном только читаются в разных аналитических разрезах».
Что такое движок MergeTree и почему именно он используется чаще всего?
MergeTree — семейство основных таблиц-движков ClickHouse, хранящих данные отсортированными по указанному ключу и физически объединяющих (merge) данные из разных вставок в фоне для эффективного хранения и быстрого чтения; именно на MergeTree и его вариациях строится подавляющее большинство реальных таблиц ClickHouse.
Нужен ли для ClickHouse отдельный мощный сервер или подойдёт обычный VPS?
Для небольших и средних объёмов данных (до нескольких десятков или сотен гигабайт с умеренной частотой запросов) вполне достаточно обычного VPS с несколькими ядрами и SSD — ClickHouse не требует специализированного железа для начала работы, хотя для по-настоящему больших объёмов и высокой конкурентной нагрузки со временем может понадобиться более мощная конфигурация или кластер из нескольких узлов.
Чем ClickHouse отличается от Elasticsearch для хранения логов?
Оба применимы для хранения и анализа логов, но ClickHouse обычно эффективнее по использованию диска и быстрее для агрегационных запросов (суммы, count, group by по большим объёмам), тогда как Elasticsearch сильнее в полнотекстовом поиске по содержимому логов — выбор часто зависит от того, что важнее: быстрая агрегация метрик и структурированный анализ или гибкий полнотекстовый поиск по свободному тексту.
Можно ли использовать ClickHouse без предварительного проектирования схемы под конкретные запросы?
Не рекомендуется — производительность ClickHouse сильно зависит от правильно подобранного ключа сортировки таблицы (ORDER BY), соответствующего реальному паттерну фильтрации запросов; таблица со случайно выбранным или неподходящим ключом сортировки может показывать заметно худшую производительность, чем спроектированная под конкретные типичные запросы.
Есть ли у ClickHouse встроенная репликация и отказоустойчивость?
Да, движки семейства ReplicatedMergeTree обеспечивают репликацию данных между узлами через ZooKeeper или встроенный ClickHouse Keeper, но настройка полноценного отказоустойчивого кластера заметно сложнее одноузловой установки и оправдана только при реальной потребности в высокой доступности или горизонтальном масштабировании.
Насколько сложно перейти с MySQL на ClickHouse для аналитических отчётов, если основные данные уже хранятся в MySQL?
Типичный паттерн — не полная замена MySQL, а сосуществование: транзакционные данные остаются в MySQL, а в ClickHouse периодически или потоково реплицируются нужные для аналитики данные (например, через ETL-процесс, Debezium/CDC или простую периодическую выгрузку), и уже к ClickHouse обращаются построители отчётов и дашбордов, не нагружая основную транзакционную базу тяжёлыми аналитическими запросами.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.