Мониторинг сервера с Prometheus и Grafana
Как устроена pull-модель Prometheus, зачем нужен node_exporter, как построить первый дашборд в Grafana и настроить базовые оповещения через Alertmanager на своём VPS.
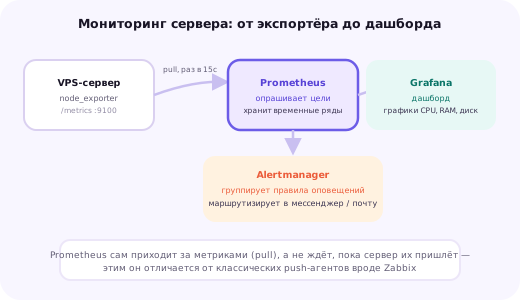
Архитектура Prometheus: pull-модель и экспортёры
Prometheus — система мониторинга и сбора временных рядов метрик, построенная вокруг модели активного опроса (pull): вместо того чтобы ждать, пока мониторируемые системы сами отправят данные, сервер Prometheus по расписанию сам обращается к заранее настроенному списку целей (targets) и забирает текущие значения метрик через простой HTTP-эндпоинт в текстовом формате.
Сами метрики на мониторируемых системах предоставляют не сами приложения напрямую, а специальные лёгкие процессы — экспортёры (exporters). Экспортёр опрашивает операционную систему или конкретное приложение через доступные ему интерфейсы (файловую систему /proc и /sys для системных метрик, внутреннее API для метрик конкретного приложения вроде базы данных или веб-сервера) и отдаёт результат в унифицированном текстовом формате, который Prometheus умеет разбирать.
Такая архитектура даёт несколько практических преимуществ: сервер Prometheus всегда точно знает, какие цели должны отвечать (и может сам заметить, что цель перестала отвечать, что само по себе уже полезный сигнал), настройка новой цели сводится к добавлению одной записи в конфигурации без изменений на стороне мониторируемого сервера сверх установки самого экспортёра, а нагрузка на сеть предсказуема и контролируется интервалом опроса, задаваемым централизованно на стороне Prometheus, а не десятками независимо настроенных агентов.
Установка Prometheus и node_exporter на VPS
node_exporter — стандартный экспортёр для сбора базовых системных метрик: загрузка процессора, использование памяти, дисковое пространство, сетевой трафик, число открытых файловых дескрипторов и десятки других показателей уровня операционной системы. Он устанавливается на каждый сервер, состояние которого нужно мониторить.
useradd --no-create-home --shell /usr/sbin/nologin node_exporter
wget https://github.com/prometheus/node_exporter/releases/download/v1.8.0/node_exporter-1.8.0.linux-amd64.tar.gz
tar xvf node_exporter-1.8.0.linux-amd64.tar.gz
cp node_exporter-1.8.0.linux-amd64/node_exporter /usr/local/bin/
chown node_exporter:node_exporter /usr/local/bin/node_exporter# /etc/systemd/system/node_exporter.service
[Unit]
Description=Node Exporter
After=network.target
[Service]
User=node_exporter
ExecStart=/usr/local/bin/node_exporter
[Install]
WantedBy=multi-user.targetПосле запуска службы через systemctl enable --now node_exporter метрики становятся доступны по адресу вида http://server-ip:9100/metrics в виде простого текста — этот же адрес и порт нужно добавить в конфигурацию Prometheus как одну из целей опроса. Сам сервер Prometheus устанавливается аналогичным образом на отдельной машине, отведённой под мониторинг, и настраивается через единый конфигурационный файл prometheus.yml.
# prometheus.yml
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: "node"
    static_configs:
      - targets: ["10.0.0.11:9100", "10.0.0.12:9100"]
Основы PromQL: выборка и агрегация метрик
PromQL — язык запросов Prometheus, спроектированный вокруг работы с временными рядами. Простейший запрос — просто имя метрики, возвращающее её текущее значение по всем целям, у которых эта метрика есть, вместе с набором меток (labels), идентифицирующих конкретный источник данных.
node_memory_MemAvailable_bytes
node_memory_MemAvailable_bytes{instance="10.0.0.11:9100"}
Большинство практически полезных запросов требуют не мгновенного значения, а скорости изменения счётчика за интервал времени — например, метрика node_cpu_seconds_total монотонно растёт и сама по себе малополезна для дашборда, но функция rate() рассчитывает среднюю скорость её роста за указанный интервал, что и даёт привычную загрузку процессора в процентах.
# загрузка процессора в режиме, отличном от простоя, усреднённая за 5 минут
100 - (avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100)
Агрегирующие функции вроде sum, avg, max в сочетании с оператором by (группировка по указанной метке) позволяют, например, посчитать суммарный сетевой трафик по всем серверам определённой роли или найти сервер с максимальной загрузкой диска среди целой группы — освоение десятка таких базовых функций покрывает подавляющее большинство практических запросов, нужных для дашбордов и условий оповещений, без необходимости в дальнейшем глубоком погружении в язык.
Подключение Grafana как источника данных
Grafana — отдельный инструмент визуализации, устанавливаемый обычно на тот же сервер, что и Prometheus, или на другую выделенную машину мониторинга. После установки и первого входа в веб-интерфейс (по умолчанию на порту 3000) первый шаг — подключение Prometheus в качестве источника данных.
apt install -y apt-transport-https software-properties-common
wget -q -O - https://apt.grafana.com/gpg.key | gpg --dearmor | tee /usr/share/keyrings/grafana.gpg > /dev/null
echo "deb [signed-by=/usr/share/keyrings/grafana.gpg] https://apt.grafana.com stable main" | tee /etc/apt/sources.list.d/grafana.list
apt update && apt install -y grafana
systemctl enable --now grafana-server
В веб-интерфейсе, в разделе Connections → Data sources, добавляется новый источник типа Prometheus с указанием адреса сервера Prometheus (обычно http://localhost:9090, если оба сервиса на одной машине). После сохранения подключения Grafana может выполнять к этому источнику произвольные PromQL-запросы для построения панелей.
Дальше не обязательно строить дашборд с нуля вручную — сообщество Grafana поддерживает общедоступную библиотеку готовых дашбордов, и для node_exporter существует широко используемый готовый дашборд (известный как «Node Exporter Full»), импортируемый по числовому идентификатору прямо из интерфейса Grafana и сразу показывающий десятки полезных панелей — загрузку процессора, память, диски, сеть — без ручной настройки каждой панели по отдельности.
Построение собственного базового дашборда
Готовый импортированный дашборд закрывает большинство типовых потребностей, но для специфичных метрик приложения (например, число активных соединений с базой данных, длина очереди задач, время ответа собственного API) потребуется добавить панели вручную. Создание панели в Grafana сводится к указанию PromQL-запроса, выбору типа визуализации (график, счётчик, таблица, тепловая карта) и настройке подписей и пороговых значений цвета.
# запрос для панели «использование диска в процентах»
100 - ((node_filesystem_avail_bytes{mountpoint="/"} * 100) / node_filesystem_size_bytes{mountpoint="/"})
Разумная практика при построении собственного дашборда — не пытаться уместить на одну страницу все существующие метрики, а сгруппировать панели по логическому назначению: отдельная строка для ресурсов операционной системы (CPU, память, диск), отдельная — для сетевого трафика, отдельная — для специфичных метрик конкретного приложения. Такая структура заметно упрощает первичную диагностику при инциденте, когда важно быстро понять, в какой области искать причину проблемы.
Grafana также поддерживает переменные дашборда (например, выбор конкретного сервера из выпадающего списка вверху страницы), что позволяет использовать один и тот же набор панелей для мониторинга произвольного числа серверов без создания отдельного дашборда для каждого — переменная подставляется в PromQL-запрос каждой панели вместо жёстко заданного имени инстанса.
Базовые оповещения через Alertmanager
Мониторинг сам по себе, без оповещений, требует, чтобы кто-то регулярно и вручную заглядывал в дашборд, — на практике это ненадёжно, и полноценная система мониторинга должна уметь сама сообщать о проблеме. В экосистеме Prometheus за это отвечает отдельный компонент — Alertmanager, получающий от Prometheus сработавшие правила оповещений и решающий, кому, как и когда об этом сообщить.
# правило в Prometheus: alert.rules.yml
groups:
  - name: node-alerts
    rules:
      - alert: HighDiskUsage
        expr: 100 - ((node_filesystem_avail_bytes{mountpoint="/"} * 100) / node_filesystem_size_bytes{mountpoint="/"}) > 85
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Диск заполнен более чем на 85% на {{ $labels.instance }}"
Условие for: 10m в примере выше принципиально важно для практической полезности оповещения — оно требует, чтобы условие оставалось истинным непрерывно в течение указанного времени, прежде чем оповещение реально сработает, что отсекает кратковременные всплески (например, разовую фоновую задачу, временно нагрузившую диск логами) от действительно устойчивой проблемы, требующей вмешательства.
# alertmanager.yml — простой маршрут в один канал
route:
  receiver: "default"
receivers:
  - name: "default"
    webhook_configs:
      - url: "https://example.ru/hooks/alertmanager"
Alertmanager поддерживает более сложную маршрутизацию по меткам оповещения (например, критичные production-оповещения — сразу в мессенджер дежурного, менее срочные — сводкой по почте раз в час), группировку схожих оповещений в одно уведомление вместо потока отдельных сообщений при массовом сбое, а также временное подавление (silence) уже известной и обрабатываемой проблемы, чтобы не получать повторные уведомления о том, что уже находится в работе.
Практические ограничения и когда стека достаточно
Полноценный стек Prometheus плюс Grafana плюс Alertmanager требует отдельного сервера или как минимум заметной доли ресурсов существующего VPS под саму систему мониторинга, а также времени на первоначальную настройку и последующую поддержку — обновление версий, ротацию хранимых данных, поддержание актуальности правил оповещений по мере изменения инфраструктуры. Для проекта с одним небольшим сервером и владельцем, который сам же его администрирует, эти затраты нередко превышают практическую пользу по сравнению с более простыми готовыми решениями внешнего uptime-мониторинга.
Связка полностью оправдывает себя, когда серверов несколько и нужна единая точка сбора метрик со всех них, когда встроенных простых проверок «сайт отвечает или нет» недостаточно и требуется детальная история конкретных внутренних показателей приложения (длина очереди, число соединений с базой, время выполнения фоновых задач), или когда команда уже располагает опытом настройки и поддержки подобных систем и не считает эту работу дополнительной нагрузкой.
Разумный практический путь для растущего проекта — начать с простого внешнего мониторинга доступности сайта и базовых системных алертов от провайдера VPS, и переходить к полноценному Prometheus и Grafana в тот момент, когда реальная потребность в детальной истории метрик и собственных условиях оповещений станет очевидной из практики, а не настраивать сложный стек заранее «на будущее» без конкретной задачи, которую он должен решать прямо сейчас.
Хранение временных рядов и срок ретеншна
Prometheus по умолчанию хранит собранные данные во встроенной локальной базе временных рядов (TSDB) прямо на диске сервера, на котором он работает, с настраиваемым сроком хранения — по умолчанию 15 дней. Для мониторинга небольшого числа серверов через node_exporter этого обычно достаточно и не требует какой-либо дополнительной инфраструктуры сверх самого Prometheus.
# запуск Prometheus с увеличенным сроком хранения
prometheus --config.file=/etc/prometheus/prometheus.yml --storage.tsdb.retention.time=90d
Более долгий срок хранения увеличивает объём занимаемого диска пропорционально числу собираемых метрик и частоте опроса, и на практике для большинства проектов на VPS вполне достаточно 15–30 дней истории — этого хватает, чтобы сравнить текущую нагрузку с состоянием месяц назад и заметить постепенную деградацию, не превращая сервер мониторинга в отдельную задачу по управлению большим объёмом хранимых данных.
Для сценариев, где нужна более долгая история или мониторинг действительно большого числа серверов, локальное хранилище Prometheus плохо масштабируется горизонтально, и на этот случай существуют решения удалённого долгосрочного хранения (remote write в специализированные системы вроде Thanos, Cortex или Mimir) — но для типичной задачи мониторинга собственной инфраструктуры на нескольких VPS это уже избыточная сложность, оправданная только при реально большом масштабе.
Отказоустойчивость: кто мониторит сам Prometheus
Логичный вопрос, который стоит продумать сразу при внедрении системы мониторинга: что происходит, если сам сервер с Prometheus и Grafana выйдет из строя или станет недоступен — команда в этот момент рискует остаться одновременно и без реального сервиса (если сбой связан с общей проблемой инфраструктуры), и без инструмента, который должен был об этом сообщить.
Базовая практическая мера — не размещать сервер мониторинга на той же физической машине или в том же сегменте сети, что и мониторируемые им критичные сервисы, чтобы сбой основной инфраструктуры не выключал одновременно и наблюдение за ней. Для более серьёзных требований к отказоустойчивости используется дополнительный, независимый и намеренно упрощённый механизм проверки доступности самого стека мониторинга — например, простой внешний сервис проверки, что Prometheus и Grafana отвечают, работающий полностью отдельно от основной инфраструктуры и не зависящий от неё.
Alertmanager дополнительно поддерживает правило heartbeat — специальное оповещение, которое намеренно всегда находится в сработавшем состоянии и непрерывно отправляется во внешнюю систему проверки; если поток таких heartbeat-сообщений внезапно прерывается, это явный сигнал, что сама система мониторинга перестала функционировать, а не что все проблемы на мониторируемых серверах чудесным образом исчезли.
Для небольшой инфраструктуры из нескольких VPS полноценное резервирование самого Prometheus (второй независимый инстанс, параллельно опрашивающий те же цели) обычно избыточно по трудозатратам относительно реальной пользы — достаточно упомянутого внешнего heartbeat-контроля и регулярной резервной копии конфигурации и, при необходимости, самой базы TSDB, чтобы после серьёзного сбоя сервера мониторинга можно было быстро поднять его заново на новой машине, не восстанавливая настройку целей и правил оповещений вручную с нуля по памяти.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Чем Prometheus принципиально отличается от привычных систем мониторинга вроде Zabbix?
Ключевое отличие — модель сбора данных. Zabbix и похожие системы традиционно используют push-модель, где агент на сервере сам отправляет метрики на центральный сервер. Prometheus работает по pull-модели: сервер Prometheus сам через определённые интервалы опрашивает заранее известные адреса (эндпоинты экспортёров), забирая текущие значения метрик в простом текстовом формате.
Нужно ли ставить Prometheus на каждый сервер, который нужно мониторить?
Нет, обычно наоборот — один сервер Prometheus (или небольшой кластер для отказоустойчивости) опрашивает множество целей. На каждом мониторимом сервере устанавливается лёгкий экспортёр (например, node_exporter), а сам Prometheus и Grafana могут работать на отдельном, выделенном под мониторинг сервере.
Что такое PromQL и обязательно ли его знать, чтобы начать пользоваться Grafana?
PromQL — собственный язык запросов Prometheus для выборки и агрегации метрик. Для базовых готовых дашбордов (например, официального дашборда Node Exporter Full) глубокое знание PromQL не требуется — но для построения собственных панелей или настройки условий оповещений разобраться с основными функциями (rate, avg, sum by) со временем придётся.
Сколько места на диске занимает база данных Prometheus?
Зависит от количества метрик, частоты опроса и срока хранения, но для мониторинга нескольких серверов через node_exporter с настройками по умолчанию (интервал опроса 15 секунд, хранение 15 дней) речь обычно идёт о нескольких гигабайтах — Prometheus эффективно сжимает временные ряды, но при добавлении множества дополнительных экспортёров объём нужно периодически перепроверять.
Можно ли использовать Grafana без Prometheus?
Да, Grafana — это отдельный инструмент визуализации, поддерживающий десятки источников данных помимо Prometheus (различные базы данных, облачные сервисы мониторинга, файлы логов), но связка именно с Prometheus — самая распространённая и хорошо задокументированная комбинация для мониторинга собственной инфраструктуры.
Как Alertmanager решает, кому и когда отправлять уведомление?
Alertmanager получает от Prometheus сработавшие правила оповещений и группирует, дедуплицирует и маршрутизирует их согласно настроенной конфигурации маршрутизации (route) — например, критичные оповещения сразу в мессенджер дежурного, а менее срочные — раз в час сводкой на почту, с возможностью временного подавления (silence) уже известных проблем.
Стоит ли разворачивать весь этот стек на маленьком VPS с одним сайтом?
Для одного небольшого проекта полноценный стек Prometheus плюс Grafana обычно избыточен по сложности настройки и поддержки по сравнению с более простыми решениями вроде готовых сервисов uptime-мониторинга — связка оправдывает себя при нескольких серверах или потребности в детальной истории метрик и собственных условиях оповещений, которые встроенные простые решения не покрывают.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.