Репликация MySQL: master-slave и master-master
Разбираем настройку репликации MySQL на основе бинарных логов: GTID против позиционной репликации, реальные сценарии применения, типичные проблемы вроде отставания и split-brain, и мониторинг статуса.
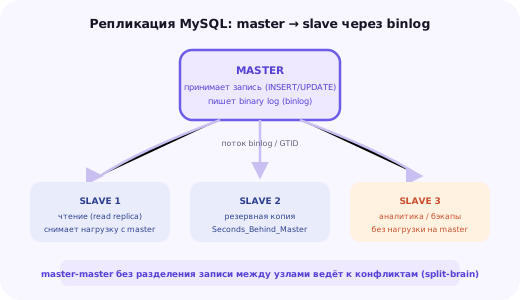
Зачем нужна репликация MySQL
Репликация MySQL — это механизм, при котором изменения, произошедшие на одном сервере базы данных (мастере), автоматически передаются и применяются на одном или нескольких других серверах (репликах), поддерживающих у себя актуальную копию тех же данных практически в реальном времени.
Три основных практических сценария применения репликации редко пересекаются друг с другом напрямую, но часто комбинируются на одном и том же проекте по мере его роста. Первый — масштабирование чтения: тяжёлые аналитические запросы или большой поток запросов на чтение от множества посетителей сайта распределяются между несколькими репликами, снимая эту нагрузку с единственного мастера, который остаётся ответственным только за запись. Второй — резервное копирование без нагрузки на production: снятие полной резервной копии с реплики не создаёт дополнительной нагрузки на основной сервер, обслуживающий реальных пользователей. Третий — отказоустойчивость: при аварии мастера одна из реплик может быть повышена (promote) до нового мастера, сократив время простоя сервиса.
Репликация не заменяет резервное копирование — она защищает от отказа оборудования, но мгновенно реплицирует и любую логическую ошибку вроде случайного удаления данных, если та была выполнена как обычная транзакция на мастере.
Важное практическое ограничение репликации, о котором часто забывают
Эта статья разбирает механизм репликации на основе бинарных логов, различие между GTID и позиционной репликацией, практическую настройку схемы master-slave, риски и особые случаи схемы master-master, а также разбирает типичные проблемы вроде отставания реплики и способы мониторинга состояния репликации.
Как работает репликация на основе бинарных логов
В основе классической репликации MySQL лежит бинарный лог (binary log, binlog) — последовательная запись всех изменений данных, выполненных на сервере, которую MySQL и так ведёт для собственных целей (например, для восстановления после сбоя). Репликация переиспользует этот же механизм: реплика подключается к мастеру как специальный клиент и запрашивает поток событий из его бинарного лога.
# /etc/mysql/mysql.conf.d/mysqld.cnf на мастере
[mysqld]
server-id = 1
log_bin = /var/log/mysql/mysql-bin.log
binlog_format = ROW
Каждый сервер в топологии репликации — и мастер, и все реплики — обязан иметь уникальный числовой server-id, который используется для идентификации источника изменений и предотвращения зацикливания событий между узлами. Формат binlog_format = ROW записывает в бинарный лог не сам SQL-запрос, а конкретные изменённые строки — это надёжнее построчного текстового формата STATEMENT, поскольку исключает расхождения, возможные при использовании в запросе недетерминированных функций вроде NOW() или RAND(), результат которых может отличаться при повторном выполнении того же самого текста запроса на другом сервере.
На стороне реплики отдельный поток (IO thread) подключается к мастеру и непрерывно копирует новые события бинарного лога в собственный локальный файл — релейный лог (relay log), а второй, независимый поток (SQL thread) последовательно читает этот релейный лог и применяет содержащиеся в нём изменения к собственной копии данных. Разделение на два независимых потока позволяет реплике продолжать получать (и сохранять на диск) новые события от мастера, даже если применение уже полученных изменений временно замедлилось.
GTID против позиционной репликации
Классическая, изначальная схема репликации MySQL полагается на позицию — конкретное имя файла бинарного лога и числовое смещение (offset) внутри него, с которого реплика должна начать читать поток изменений. Эта схема работает надёжно, пока топология репликации стабильна, но становится проблематичной при необходимости переключить реплику на другой источник — например, при аварии текущего мастера и необходимости подключиться к другой, ранее равноправной реплике.
-- Настройка позиционной репликации на реплике (устаревающий подход)
CHANGE MASTER TO
  MASTER_HOST='10.0.0.10',
  MASTER_USER='repl',
  MASTER_PASSWORD='ПарольРепликации',
  MASTER_LOG_FILE='mysql-bin.000042',
  MASTER_LOG_POS=15672;
GTID (Global Transaction Identifier), появившийся в MySQL 5.6, решает эту проблему принципиально иначе: каждой транзакции при её первом выполнении на любом сервере присваивается глобально уникальный идентификатор, сохраняющийся неизменным при передаче этой же транзакции на любую реплику. Это делает саму репликацию декларативной с точки зрения администратора — не нужно вычислять точную позицию в конкретном файле лога, достаточно указать, что реплика должна получать транзакции от определённого мастера, а MySQL сама определит, какие GTID уже применены локально, а какие ещё нет.
# на мастере и на всех репликах
[mysqld]
gtid_mode = ON
enforce_gtid_consistency = ON

# на реплике:
CHANGE MASTER TO
  MASTER_HOST='10.0.0.10',
  MASTER_USER='repl',
  MASTER_PASSWORD='ПарольРепликации',
  MASTER_AUTO_POSITION=1;
Директива MASTER_AUTO_POSITION=1 заменяет собой ручное указание файла и смещения — MySQL автоматически определит нужную стартовую точку на основе уже применённых GTID на самой реплике. Это особенно ценно при переключении реплики на другой источник данных при отказе исходного мастера: с GTID реплика способна корректно продолжить репликацию с любого сервера, содержащего нужные транзакции, без ручного вычисления позиции в чужом бинарном логе.
Пошаговая настройка master-slave репликации
Первый шаг — создание отдельного пользователя MySQL с правами только на репликацию на мастере, без предоставления ему каких-либо иных привилегий, что ограничивает потенциальный ущерб при компрометации учётных данных этого пользователя.
CREATE USER 'repl'@'%' IDENTIFIED BY 'ПарольРепликации';
GRANT REPLICATION SLAVE ON *.* TO 'repl'@'%';
FLUSH PRIVILEGES;
Второй шаг — снятие консистентного снимка данных мастера на момент, зафиксированный в бинарном логе, и перенос этого снимка на будущую реплику, поскольку сама репликация передаёт только новые изменения, произошедшие после её настройки, а не исторические данные, накопленные до этого момента.
mysqldump --all-databases --master-data=2 --single-transaction -u root -p > full_dump.sqlФлаг --master-data=2 записывает в файл дампа комментарий с точной позицией бинарного лога (или актуальным набором GTID при включённом gtid_mode) на момент снятия дампа — эта информация понадобится для точного указания стартовой точки репликации на реплике. Флаг --single-transaction обеспечивает согласованность снимка без блокировки таблиц на всё время выполнения дампа, что критично для активно используемой production-базы данных.
mysql -u root -p < full_dump.sql
-- затем на реплике:
CHANGE MASTER TO MASTER_HOST='10.0.0.10', MASTER_USER='repl',
  MASTER_PASSWORD='ПарольРепликации', MASTER_AUTO_POSITION=1;
START REPLICA;
После восстановления дампа на будущей реплике и выполнения CHANGE MASTER TO с последующей командой START REPLICA (в старых версиях — START SLAVE) реплика начинает получать и применять поток изменений с мастера начиная с момента снятия дампа, постепенно приходя к состоянию, полностью синхронному с текущим состоянием мастера.
Сценарий 1: масштабирование чтения
Наиболее распространённое практическое применение репликации — разгрузка мастера от тяжёлых или частых запросов на чтение путём направления их на одну или несколько реплик, оставляя мастер полностью выделенным под операции записи (INSERT, UPDATE, DELETE).
На уровне приложения такое разделение обычно реализуется через отдельные настройки подключения для чтения и записи — многие современные фреймворки и ORM поддерживают эту схему из коробки, автоматически направляя запросы на выборку данных на пул реплик, а операции изменения данных — исключительно на мастер, без необходимости вручную выбирать соединение в каждом отдельном месте кода приложения.
Важная практическая оговорка этой схемы — задержка репликации (о которой подробнее в отдельном разделе ниже) означает, что данные, только что записанные через мастер, могут ещё какое-то короткое время отсутствовать на реплике. Для сценариев, где пользователь сразу после сохранения формы ожидает увидеть только что введённые данные, наивное распределение чтения на реплику способно показать ему устаревшую версию — это стоит либо явно учитывать в логике приложения (читать критичные для UX данные сразу с мастера), либо использовать более сложные схемы согласованного чтения.
Сценарий 2: резервное копирование и отказоустойчивость
Снятие полного резервного дампа тяжёлой базы данных — операция, потенциально создающая заметную нагрузку на диск и процессор в течение всего времени своего выполнения; выполнение такого дампа на реплике вместо мастера полностью изолирует эту нагрузку от production-трафика, обслуживаемого мастером в реальном времени.
Для отказоустойчивости реплика служит готовой к использованию горячей резервной копией данных: при аварии мастера одна из реплик может быть переключена (promote) в роль нового мастера — то есть выведена из режима read_only и переориентирована на приём записи, а остальные реплики и приложение перенастраиваются на новый мастер. Скорость такого переключения и минимизация потери данных заметно выше при использовании GTID, поскольку не требуется вручную вычислять точную позицию, с которой должны продолжить читать оставшиеся реплики.
SET GLOBAL read_only = OFF;
SET GLOBAL super_read_only = OFF;
Полностью автоматическое переключение (failover) без вмешательства администратора требует дополнительной инфраструктуры поверх самой репликации MySQL — специализированных инструментов вроде Orchestrator, MHA (Master High Availability) или встроенной групповой репликации (Group Replication) MySQL, которые берут на себя обнаружение отказа мастера и координацию переключения, включая недопущение одновременного существования двух активных мастеров.
Master-master репликация и риск split-brain
В отличие от классической схемы master-slave с единственным источником записи, master-master репликация настраивает два сервера так, что каждый из них является одновременно и мастером, и репликой другого — оба сервера способны принимать запись, и изменения на каждом из них реплицируются на другой.
На практике эта схема заметно более рискованна, чем может показаться на первый взгляд: если оба сервера одновременно (например, из-за временной сетевой проблемы между ними) примут конфликтующие изменения одних и тех же строк, при восстановлении связи между узлами такие конфликты не разрешаются автоматически и корректно в общем случае — ситуация, известная как split-brain, способна привести к рассинхронизации и частичной потере одной из конфликтующих версий данных.
Master-master репликация MySQL не обеспечивает автоматического разрешения конфликтов записи — при её использовании ответственность за предотвращение одновременной конфликтующей записи в оба узла целиком ложится на архитектуру приложения.
Ключевое ограничение схемы master-master, которое часто недооценивают при выборе архитектуры
На практике master-master чаще всего используют не для реальной параллельной записи с обеих сторон одновременно, а как способ быстрого переключения между двумя равноправными узлами (active-passive), где запись в конкретный момент времени ведётся только через один из них, а второй держится наготове для быстрого переключения при аварии первого — это заметно снижает риск split-brain по сравнению с полноценной активной записью на оба узла одновременно.
Отставание реплики: причины и диагностика
Отставание реплики (replication lag) — это разница по времени между применением конкретного изменения на мастере и его фактическим применением на соответствующей реплике. Основная структурная причина отставания — то, что SQL-поток на реплике по умолчанию однопоточно применяет полученные изменения последовательно, тогда как на мастере запись могла происходить из множества параллельных соединений одновременно.
SHOW REPLICA STATUS\G
-- ключевые поля:
-- Seconds_Behind_Source: 0
-- Replica_IO_Running: Yes
-- Replica_SQL_Running: Yes
Поле Seconds_Behind_Source (в более старых версиях — Seconds_Behind_Master) показывает текущее отставание в секундах — ненулевое, но небольшое и стабильное значение обычно не является проблемой, тогда как постоянно растущее значение сигнализирует, что реплика не успевает обрабатывать поток изменений с той же скоростью, с которой они поступают от мастера, и разрыв будет только увеличиваться без вмешательства.
Для снижения отставания современные версии MySQL и MariaDB поддерживают параллельное применение реплицированных транзакций несколькими потоками одновременно (multi-threaded replication) через директиву replica_parallel_workers — это заметно ускоряет применение потока изменений на реплике, если сама нагрузка на мастере допускает параллельное применение без нарушения порядка зависимых транзакций.
SET GLOBAL replica_parallel_workers = 4;Помимо интенсивности записи на мастере, отставание нередко вызывается более медленным оборудованием реплики по сравнению с мастером (особенно дисковой подсистемой) или тяжёлыми запросами на чтение, выполняемыми непосредственно на самой реплике и временно конкурирующими за ресурсы процессора и диска с применением потока репликации.
Типичные ошибки при настройке репликации
Отсутствие уникального server-id на каждом узле — при совпадении идентификаторов реплика может отклонять события мастера как собственные же изменения, что приводит к неработающей или частично неработающей репликации без явной и понятной ошибки в логе.
Настройка репликации без предварительного согласованного снимка данных (mysqldump с --single-transaction и --master-data, или аналогичный инструмент вроде Percona XtraBackup) — реплика в этом случае начинает с произвольного, несогласованного состояния данных и никогда не догонит мастер корректно.
Полное доверие репликации как единственной стратегии резервного копирования — логическая ошибка вроде случайного DELETE без условия WHERE реплицируется на все реплики так же надёжно и быстро, как и любое легитимное изменение, не оставляя возможности восстановить удалённые данные из самой реплики.
Использование master-master для реальной параллельной записи с обеих сторон без продуманной стратегии предотвращения конфликтов на уровне приложения — прямой путь к трудноисправимому расхождению данных между узлами при первом же реальном конфликте записи.
Отсутствие мониторинга Seconds_Behind_Source и состояния потоков репликации — незамеченное растущее отставание или остановившийся из-за ошибки SQL-поток на реплике означает, что она постепенно перестаёт быть актуальной копией данных, и это обнаруживается обычно уже после того, как устаревшие данные показаны реальным пользователям или использованы для ошибочного решения о переключении на неё как на новый мастер.
Итог: репликация как инструмент масштабирования и надёжности, а не резервная копия
Репликация MySQL на основе бинарных логов остаётся зрелым и надёжным механизмом для распределения нагрузки на чтение, снятия резервных копий без влияния на production и построения базовой отказоустойчивости — GTID заметно упрощает управление топологией по сравнению с классической позиционной репликацией, особенно в сценариях переключения на другой источник при аварии.
Ключевое, что стоит держать в голове при проектировании схемы репликации, — она не заменяет полноценное резервное копирование и требует осторожного архитектурного подхода в схеме master-master из-за реального риска конфликтов записи и split-brain. Если не уверены, какая топология репликации подойдёт вашему проекту — простая master-slave для масштабирования чтения или что-то более сложное — опишите задачу в заявке внизу страницы, поможем спроектировать схему под вашу нагрузку.
После настройки любой топологии репликации обязательно нужен постоянный мониторинг состояния — как минимум значения Seconds_Behind_Source и статуса обоих рабочих потоков на каждой реплике — поскольку тихо остановившаяся или сильно отстающая реплика создаёт ложное чувство защищённости, которое обнаруживает свою несостоятельность именно в момент реальной необходимости переключиться на неё при аварии основного сервера.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Реплицируются ли уже существующие данные при настройке репликации?
Автоматически — нет, репликация на основе бинарных логов передаёт только новые изменения, произошедшие после её настройки, поэтому перед запуском реплики на неё нужно перенести полный снимок данных мастера на момент, зафиксированный в бинарном логе, и только потом запускать сам процесс репликации с этой точки.
В чём практическая разница между GTID и позиционной репликацией?
Позиционная репликация ссылается на конкретный файл бинарного лога и смещение в нём (что делает переключение на другой источник репликации при аварии мастера трудоёмким и подверженным ошибкам), тогда как GTID присваивает каждой транзакции глобальный уникальный идентификатор, что делает переключение между источниками репликации и восстановление после сбоя заметно проще и надёжнее.
Что такое отставание (lag) реплики и почему оно возникает?
Это разница по времени между применением конкретного изменения на мастере и его фактическим применением на реплике — репликация MySQL по умолчанию однопоточная на уровне применения событий на реплике, поэтому при высокой интенсивности записи на мастере реплика может не успевать применять поток изменений в реальном времени.
Можно ли использовать реплику для записи данных?
В классической конфигурации master-slave — нет, реплика доступна только для чтения (read_only=1), и запись напрямую в неё нарушает согласованность данных между мастером и репликой; для записи с нескольких узлов существует отдельная схема master-master, требующая гораздо более осторожного проектирования.
Что такое split-brain в контексте master-master репликации?
Ситуация, когда оба узла в конфигурации master-master одновременно принимают конфликтующие записи (например, из-за временной потери связи между ними) — при восстановлении связи такие конфликтующие изменения могут привести к рассинхронизации данных, которую MySQL не способен разрешить автоматически без потери одной из версий записи.
Как быстро проверить, что реплика не отстаёт и работает корректно?
Командой SHOW REPLICA STATUS (или устаревшей SHOW SLAVE STATUS в более старых версиях) на самой реплике — ключевые поля Seconds_Behind_Source (или Seconds_Behind_Master) показывают отставание в секундах, а Replica_IO_Running и Replica_SQL_Running должны оба быть в состоянии Yes для полностью исправной репликации.
Заменяет ли репликация резервное копирование?
Нет — репликация защищает от отказа оборудования и распределяет нагрузку на чтение, но не защищает от логических ошибок вроде случайного DELETE без WHERE или порчи данных приложением: такая ошибка мгновенно реплицируется на все реплики точно так же, как и любое другое легитимное изменение, поэтому отдельное полноценное резервное копирование остаётся обязательным.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.