Connection pooling: PgBouncer и ProxySQL
Зачем нужен пул соединений между приложением и базой данных: режимы пулинга PgBouncer для PostgreSQL, возможности маршрутизации запросов в ProxySQL для MySQL и когда пула на уровне приложения уже недостаточно.
Почему у баз данных есть предел числа соединений
И PostgreSQL, и MySQL ограничивают максимальное число одновременных соединений явной настройкой (max_connections в обоих случаях), и это ограничение существует не произвольно, а потому, что каждое соединение потребляет реальные ресурсы сервера — память под буферы и служебные структуры конкретного соединения, а в случае PostgreSQL — ещё и отдельный процесс операционной системы на каждое соединение, в отличие от более лёгкой модели потоков в MySQL.
Проблема возникает не тогда, когда соединений действительно нужно много одновременно активно работающих, а когда соединений открыто заметно больше, чем реально одновременно выполняющих запросы, — типичный сценарий на растущем проекте: несколько реплик приложения, каждая со своим внутренним пулом на несколько десятков соединений, суммарно легко превышают разумный лимит на стороне базы данных, при этом подавляющее большинство этих соединений в любой конкретный момент времени просто простаивают в ожидании следующего запроса от своего клиента.
Помимо самого лимита max_connections, чрезмерное число одновременных соединений создаёт и менее очевидную проблему — рост накладных расходов на переключение контекста между процессами или потоками на стороне сервера базы данных, конкуренцию за общие внутренние структуры данных сервера и, в случае PostgreSQL, рост потребления памяти пропорционально числу открытых процессов независимо от того, выполняют ли они реальную работу в данный момент.
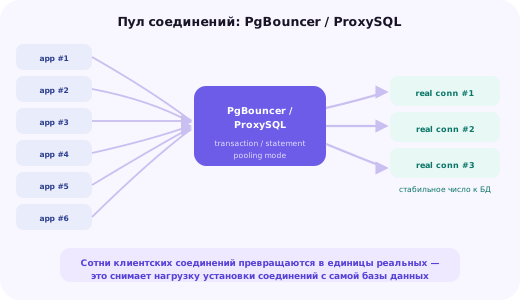
Connection pooling решает эту проблему принципиально иначе, чем простое увеличение лимита max_connections: вместо того чтобы позволить базе данных обслуживать все соединения от всех клиентов напрямую, между приложением и базой данных ставится промежуточный слой, поддерживающий заметно меньшее число реальных соединений к базе и переиспользующий их между большим числом клиентских подключений.
PgBouncer: лёгкий пулер соединений для PostgreSQL
PgBouncer — специализированный, нарочно облегчённый прокси для PostgreSQL, единственная задача которого — принимать соединения от клиентов приложения и переиспользовать заметно меньшее число реальных соединений к самой базе данных, скрывая от клиента сам факт того, что физическое соединение может переключаться между разными клиентами.
; /etc/pgbouncer/pgbouncer.ini
[databases]
myapp = host=127.0.0.1 port=5432 dbname=myapp

[pgbouncer]
listen_port = 6432
listen_addr = 127.0.0.1
auth_type = scram-sha-256
auth_file = /etc/pgbouncer/userlist.txt
pool_mode = transaction
max_client_conn = 1000
default_pool_size = 20
В этой конфигурации приложение продолжает думать, что подключается к обычному PostgreSQL — просто указывает порт 6432 вместо 5432 в строке подключения — но реально до 1000 клиентских соединений (max_client_conn) будут разделять между собой всего 20 реальных соединений к самой базе данных (default_pool_size) на каждую обслуживаемую базу. Такое соотношение возможно именно потому, что подавляющее большинство соединений в конкретный момент времени простаивают, ожидая следующего запроса, а не выполняют реальную работу постоянно.
PgBouncer сознательно устроен максимально просто и легковесно — он не разбирает и не анализирует сам текст SQL-запросов, не занимается маршрутизацией между несколькими серверами и не пытается быть полноценным балансировщиком нагрузки, а решает только одну конкретную задачу пулинга соединений, и именно эта узкая специализация делает его достаточно лёгким, чтобы держать тысячи клиентских соединений с минимальным потреблением ресурсов самого пулера.
Режимы пулинга PgBouncer: session, transaction, statement
Session pooling — самый консервативный режим: реальное соединение к базе данных закрепляется за конкретным клиентом на всё время его сессии, с момента подключения и до явного отключения, и освобождается обратно в пул только тогда, когда клиент сам закрывает соединение. Это полностью совместимо с любыми возможностями PostgreSQL, зависящими от состояния сессии, но даёт наименьший выигрыш от пулинга, поскольку долго удерживаемая, но простаивающая сессия клиента продолжает занимать реальное соединение к базе так же, как и без пулера вовсе.
[pgbouncer]
pool_mode = transaction
Transaction pooling — режим, используемый в подавляющем большинстве реальных проектов: реальное соединение возвращается в общий пул сразу же после завершения каждой транзакции клиента (даже если сама сессия клиента формально продолжается), что позволяет заметно большему числу клиентов эффективно разделять существенно меньшее число реальных соединений, поскольку соединение занято только на время выполнения конкретной транзакции, а не на всё время жизни сессии клиента.
У transaction pooling есть практические ограничения, о которых важно знать: некоторые возможности PostgreSQL, зависящие от состояния конкретного физического соединения — серверные подготовленные запросы через PREPARE, LISTEN/NOTIFY, временные таблицы с областью видимости сессии, советы блокировки уровня сессии (advisory locks) — работают ненадёжно или не работают вовсе в этом режиме, поскольку между транзакциями одного клиента реальное соединение может подмениться на совершенно другое, не хранящее это состояние.
Statement pooling — самый агрессивный режим, возвращающий соединение в пул сразу после каждого отдельного SQL-запроса, а не после целой транзакции, — он практически несовместим с обычными многошаговыми транзакциями (BEGIN ... COMMIT, охватывающими несколько запросов) и на практике применяется существенно реже, чем transaction pooling, обычно только для очень специфичных нагрузок из простых одиночных запросов без транзакционной логики.
ProxySQL: маршрутизация запросов для MySQL
ProxySQL — прокси-сервер для MySQL (и совместимых с ним СУБД вроде MariaDB и Percona Server), решающий задачу пулинга соединений аналогично PgBouncer, но дополнительно умеющий анализировать сам текст проходящих через него SQL-запросов и маршрутизировать их между разными серверами на основе гибко настраиваемых правил.
-- через административный интерфейс ProxySQL (порт 6032)
INSERT INTO mysql_servers (hostgroup_id, hostname, port)
VALUES (10, '10.0.0.10', 3306), (20, '10.0.0.11', 3306), (20, '10.0.0.12', 3306);

INSERT INTO mysql_query_rules (rule_id, active, match_pattern, destination_hostgroup, apply)
VALUES (1, 1, '^SELECT.*FOR UPDATE', 10, 1),
       (2, 1, '^SELECT', 20, 1);

LOAD MYSQL SERVERS TO RUNTIME;
LOAD MYSQL QUERY RULES TO RUNTIME;
В этом примере hostgroup 10 объединяет мастер (единственный сервер, принимающий запись), а hostgroup 20 — реплики для чтения; правила mysql_query_rules определяют, что запросы SELECT ... FOR UPDATE (требующие блокировки строк, доступной только для актуальных данных мастера) направляются на мастер, а обычные SELECT-запросы — на реплики, разгружая мастер от чтения так же, как это делает прямое разделение чтения и записи на уровне приложения, но без необходимости явно управлять этим в коде каждого запроса.
ProxySQL хранит собственную конфигурацию, включая список серверов и правила маршрутизации, в отдельной администрируемой базе SQLite, доступной через специальный административный интерфейс на отдельном порту, — изменения применяются командами LOAD ... TO RUNTIME без перезапуска самого ProxySQL, что позволяет менять состав серверов или правила маршрутизации на лету, например, при добавлении новой реплики в существующую топологию.
Помимо маршрутизации на основе типа запроса, ProxySQL поддерживает и более сложные правила — направление конкретного, заранее известного тяжёлого запроса на выделенный сервер отчётности, приоритизацию запросов от определённого пользователя приложения, и кеширование результатов часто повторяющихся идентичных запросов на короткое время прямо на уровне самого ProxySQL, снижая нагрузку на бэкенд-серверы без изменения кода приложения.
Настройка пула на стороне ProxySQL
Помимо маршрутизации, ProxySQL так же, как и PgBouncer для PostgreSQL, поддерживает собственный пул соединений к каждому серверу из hostgroup, ограничивая суммарное число реальных соединений к каждому серверу независимо от числа клиентов, подключённых к самому ProxySQL.
UPDATE global_variables SET variable_value='200'
WHERE variable_name='mysql-max_connections';
UPDATE mysql_servers SET max_connections=50 WHERE hostgroup_id=20;
LOAD MYSQL VARIABLES TO RUNTIME;
LOAD MYSQL SERVERS TO RUNTIME;
Параметр max_connections на уровне конкретного сервера в mysql_servers ограничивает, сколько реальных соединений ProxySQL откроет именно к этому серверу, что удобно для распределения нагрузки между репликами разной мощности — более слабая реплика получает меньший лимит соединений, чем более мощная, независимо от общего алгоритма распределения запросов между ними.
Важное практическое отличие ProxySQL от PgBouncer — гораздо более сложная и гибкая, но и более требовательная к пониманию конфигурация: ProxySQL хранит собственное состояние в SQLite-базе, поддерживает несколько логических слоёв конфигурации (runtime, memory, disk) с явной необходимостью применять изменения между ними, и требует более вдумчивого подхода к настройке, тогда как PgBouncer сознательно ограничен единственной задачей пулинга и его конфигурация укладывается в один текстовый файл понятной структуры.
Когда пула на уровне приложения уже недостаточно
Многие фреймворки и ORM-библиотеки предоставляют встроенный пул соединений на уровне самого приложения — например, пул в конфигурации Doctrine, SQLAlchemy или аналогичного слоя доступа к данным. Такой пул действительно снижает число новых физических соединений, открываемых конкретным процессом приложения, переиспользуя уже установленные соединения для последовательных запросов в рамках этого процесса.
Проблема этого подхода проявляется при горизонтальном масштабировании приложения: если приложение развёрнуто в виде нескольких независимых процессов или контейнеров (несколько воркеров PHP-FPM, несколько реплик в Kubernetes или просто несколько серверов приложения за балансировщиком), у каждого из них собственный, независимый пул соединений, ничего не знающий о пулах соседних инстансов — суммарное число реальных соединений к базе данных равно сумме размеров пулов всех инстансов вместе, и при добавлении новых инстансов для масштабирования приложения это суммарное число продолжает расти линейно, рано или поздно упираясь в лимит max_connections самой базы данных.
Внешний пулер вроде PgBouncer или ProxySQL решает именно эту проблему масштаба, поскольку он единственная точка, через которую проходят соединения от всех инстансов приложения вместе, и именно он, а не каждый инстанс по отдельности, определяет и контролирует суммарное реальное число соединений к базе данных, — добавление новых инстансов приложения при таком подходе увеличивает число клиентов, обслуживаемых пулом, но не обязательно увеличивает пропорционально число реальных соединений к самой базе данных.
Практический сигнал, что пора добавить внешний пулер, — рост числа одновременных подключений к базе данных пропорционально числу инстансов приложения при относительно стабильной реальной нагрузке на саму базу данных, или регулярные предупреждения и ошибки о превышении max_connections при попытке масштабировать приложение горизонтально, несмотря на то что процессор и память сервера базы данных остаются загруженными далеко не полностью.
Практические риски при внедрении пулера
Внедрение PgBouncer или ProxySQL в уже работающий проект — не абсолютно прозрачное изменение, требующее нулевого внимания к особенностям приложения: код, полагающийся на серверные подготовленные запросы, состояние сессии между транзакциями или блокировки уровня сессии, может начать вести себя неожиданно при переходе на transaction pooling, и перед внедрением стоит проверить используемый код доступа к данным на подобные зависимости.
Ошибочно заниженный размер пула (default_pool_size в PgBouncer или max_connections на бэкенд в ProxySQL) создаёт новую проблему вместо решения старой — клиенты приложения начинают заметно дольше ожидать освобождения соединения из пула в пиковые моменты нагрузки, и такая деградация иногда сложнее диагностировать, чем прямая ошибка о превышении лимита соединений самой базы данных, поскольку внешне выглядит просто как общее замедление ответа приложения без явного сообщения об ошибке.
Сам пулер становится новой единой точкой отказа в архитектуре — если PgBouncer или ProxySQL упадёт или зависнет, приложение теряет доступ к базе данных полностью, даже если сама база данных продолжает нормально работать, поэтому пулер стоит либо запускать в отказоустойчивой конфигурации с несколькими экземплярами за балансировщиком, либо как минимум держать под тем же уровнем мониторинга, что и саму базу данных, а не считать его второстепенным вспомогательным компонентом.
Мониторинг пула соединений: что стоит проверять регулярно
Развёрнутый пулер без последующего наблюдения за его состоянием создаёт ложное чувство защищённости — сам факт его установки не гарантирует, что выбранный размер пула действительно соответствует реальной нагрузке проекта, и без регулярной проверки нескольких ключевых показателей проблема с исчерпанием пула обнаруживается обычно только тогда, когда пользователи уже столкнулись с задержками или ошибками.
-- PgBouncer: подключение к специальной административной базе pgbouncer
psql -p 6432 -U pgbouncer pgbouncer -c "SHOW POOLS;"
psql -p 6432 -U pgbouncer pgbouncer -c "SHOW STATS;"
Команда SHOW POOLS показывает для каждой обслуживаемой базы данных число клиентских соединений, ожидающих освобождения слота (cl_waiting), и число реально активных серверных соединений (sv_active) — устойчиво ненулевое значение cl_waiting в обычные, не пиковые часы работы сигнализирует, что текущий размер пула (default_pool_size) недостаточен для реальной нагрузки и клиенты регулярно простаивают в очереди ожидания вместо немедленного получения соединения.
-- ProxySQL: состояние соединений к каждому бэкенду
SELECT hostgroup, srv_host, status, ConnUsed, ConnFree, Queries
FROM stats_mysql_connection_pool;
Для ProxySQL таблица stats_mysql_connection_pool показывает похожую картину для MySQL: число используемых (ConnUsed) и свободных (ConnFree) соединений к каждому конкретному серверу в каждой hostgroup, а также число обработанных запросов — стабильно нулевое значение ConnFree при активной нагрузке указывает на ту же проблему нехватки размера пула, что и растущий cl_waiting в PgBouncer, только применительно к инфраструктуре MySQL.
Помимо размера самого пула, стоит регулярно проверять и то, не выросло ли среднее время удержания одной транзакции (что при transaction pooling напрямую снижает эффективный коэффициент разделения соединений между клиентами) — долгие, неоптимизированные транзакции или забытые открытыми соединения без явного COMMIT удерживают реальное соединение к базе данных заметно дольше ожидаемого, снижая для остальных клиентов доступное число свободных слотов пула даже при формально достаточном его размере.
Итог: пулер как отдельный уровень между приложением и базой
PgBouncer и ProxySQL решают одну и ту же фундаментальную задачу — сокращение числа реальных соединений к базе данных независимо от числа клиентов, обращающихся к ней через приложение, — но с разной степенью специализации: PgBouncer сознательно прост и легковесен, ограничиваясь только пулингом, тогда как ProxySQL дополнительно предоставляет гибкую маршрутизацию запросов между несколькими серверами на основе анализа самого SQL.
Решение о внедрении такого промежуточного слоя стоит принимать не заранее "на всякий случай", а тогда, когда реальный рост числа инстансов приложения начинает упираться в лимит соединений базы данных при том, что сама база данных ещё не загружена по вычислительным ресурсам, — это явный сигнал, что проблема именно в числе соединений, а не в реальной вычислительной нагрузке. Если проект уже сталкивается с ошибками превышения лимита соединений при масштабировании, опишите текущую архитектуру в заявке внизу страницы — поможем подобрать и настроить подходящую схему пулинга.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Зачем вообще нужен отдельный пул соединений, если приложение уже использует пул на своей стороне?
Пул на уровне приложения ограничивает число соединений от одного процесса или одной реплики приложения, но при масштабировании приложения на несколько инстансов (несколько процессов PHP-FPM, несколько реплик в контейнерах) суммарное число соединений от всех инстансов вместе может легко превысить лимит базы данных, а внешний пулер вроде PgBouncer или ProxySQL ограничивает именно суммарное число реальных соединений к базе независимо от того, сколько инстансов приложения к нему подключено.
В чём разница между session, transaction и statement pooling в PgBouncer?
В session pooling соединение с базой закрепляется за клиентом на всё время его сессии и освобождается только при её завершении; в transaction pooling соединение возвращается в пул сразу после завершения каждой транзакции, позволяя гораздо большему числу клиентов разделять меньшее число реальных соединений; в statement pooling соединение возвращается в пул после каждого отдельного запроса, но такой режим несовместим с многими возможностями PostgreSQL, включая обычные многошаговые транзакции.
Можно ли использовать PREPARE и подготовленные запросы в режиме transaction pooling PgBouncer?
С ограничениями — поскольку соединение переключается между разными клиентами между транзакциями, состояние сессии (включая подготовленные на уровне соединения запросы через PREPARE) не сохраняется гарантированно между транзакциями одного клиента, и приложения, полагающиеся на такие серверные подготовленные запросы, должны либо использовать другой режим пулинга, либо перейти на клиентские подготовленные запросы, не зависящие от состояния конкретного соединения.
Зачем нужен именно ProxySQL, если у MySQL есть встроенный connection pooling через thread pool?
Thread pool в MySQL Enterprise и Percona Server оптимизирует использование потоков внутри самого сервера MySQL для уже установленных соединений, но не решает задачу сокращения числа самих TCP-соединений и не даёт возможности маршрутизировать запросы между несколькими серверами (например, направлять чтение на реплики, а запись — на мастер) — это отдельная функциональность, которую предоставляет именно ProxySQL как промежуточный слой.
Может ли ProxySQL сам решать, отправлять ли конкретный запрос на мастер или на реплику?
Да, через правила маршрутизации запросов (query rules), которые могут анализировать текст SQL-запроса (например, по регулярному выражению, определяющему, что это SELECT без явного требования свежих данных) и направлять его на сервер из пула для чтения, тогда как запросы на изменение данных автоматически направляются на мастер согласно отдельно настроенному правилу.
Нужен ли pgbouncer, если PostgreSQL и так неплохо обрабатывает большое число соединений?
Каждое соединение PostgreSQL — это отдельный процесс операционной системы, а не облегчённый поток, и создание нового процесса на каждое новое соединение заметно дороже с точки зрения ресурсов сервера (памяти и процессорного времени), чем работа с уже существующим лёгким пулом соединений PgBouncer — на высоконагруженных проектах с частым открытием новых соединений эта разница становится заметна в реальных задержках ответа.
Что произойдёт, если число реальных клиентов превысит размер пула PgBouncer или ProxySQL?
Новые запросы на подключение встанут в очередь ожидания свободного соединения из пула (поведение по умолчанию и настраиваемо по таймауту), вместо немедленного установления нового реального соединения к базе данных, — это предотвращает перегрузку самой базы данных избыточным числом соединений ценой небольшой задержки ожидания в пике нагрузки.
Можно ли использовать PgBouncer и ProxySQL одновременно на одном проекте, если используются обе базы данных?
Да, они полностью независимы друг от друга и решают одну и ту же задачу для разных СУБД — PgBouncer перед PostgreSQL и ProxySQL перед MySQL могут работать в одной и той же инфраструктуре параллельно, каждый обслуживая свою базу данных, если проект действительно использует обе.
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.