PostgreSQL: базовая настройка и тюнинг производительности
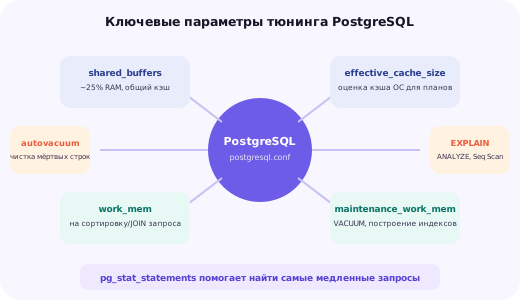
Ключевые параметры postgresql.conf — shared_buffers, work_mem, effective_cache_size, maintenance_work_mem, — управление подключениями, тюнинг autovacuum, чтение EXPLAIN ANALYZE, когда добавлять индексы и как найти медленные запросы через pg_stat_statements.
С чего начинается тюнинг: где искать postgresql.conf
PostgreSQL по умолчанию поставляется с довольно консервативными настройками, рассчитанными на то, чтобы сервер гарантированно запустился даже на минимальном по ресурсам окружении, а не на то, чтобы выжать максимум из конкретного железа. Практически любой продакшн-сервер выигрывает от осознанной настройки под собственный объём оперативной памяти и характер нагрузки.
psql -U postgres -c "SHOW config_file;"
psql -U postgres -c "SHOW data_directory;"
Основные параметры производительности собраны в файле postgresql.conf, путь к которому варьируется между дистрибутивами (часто /etc/postgresql/16/main/postgresql.conf в Debian/Ubuntu или внутри каталога данных в других сборках) — команда SHOW config_file через psql достоверно покажет точное расположение для конкретной установки, не полагаясь на предположения по умолчанию.
После изменения параметров, не требующих полного перезапуска процесса, конфигурацию можно перечитать без остановки сервера, что особенно ценно для продакшн-баз данных, где неожиданный простой нежелателен даже ради применения настройки.
psql -U postgres -c "SELECT pg_reload_conf();"shared_buffers: основной кэш данных PostgreSQL
shared_buffers определяет объём разделяемой памяти, которую PostgreSQL выделяет под собственный кэш страниц таблиц и индексов — чем больше нужных данных помещается в этот кэш, тем реже серверу приходится обращаться напрямую к диску для чтения.
shared_buffers = 4GBОбщепринятая отправная точка — около 25% физической памяти сервера, а не значительно больше. Это не интуитивно очевидно, но объясняется архитектурой PostgreSQL: помимо собственного shared_buffers, сервер активно полагается на файловый кэш операционной системы (page cache), который автоматически кэширует те же файлы данных на уровне ядра — если отдать под shared_buffers слишком большую долю памяти, операционной системе останется слишком мало места под этот дополнительный уровень кэширования, и общий эффект окажется хуже, чем при более сбалансированном распределении.
Изменение shared_buffers требует полного перезапуска процесса PostgreSQL, а не просто перечитывания конфигурации, поскольку это значение определяет размер сегмента разделяемой памяти, выделяемого один раз при старте сервера, — стоит планировать изменение этого параметра как часть окна обслуживания, а не рассчитывать на применение налету.
work_mem и maintenance_work_mem: память на операции внутри запроса
work_mem задаёт объём памяти, доступный каждой отдельной операции сортировки или хеш-соединения в рамках выполнения запроса, прежде чем PostgreSQL начнёт использовать временные файлы на диске вместо памяти, что заметно медленнее.
work_mem = 32MB
maintenance_work_mem = 512MB
Критически важная особенность work_mem, регулярно упускаемая при первой настройке, — это значение применяется на каждую операцию сортировки или хеширования отдельно, а не на всё соединение или весь сервер целиком: сложный запрос с несколькими соединениями и сортировками может задействовать несколько кратных work_mem объёмов памяти одновременно, и при большом числе параллельных таких запросов суммарное потребление памяти способно заметно превысить наивно ожидаемое значение, вплоть до исчерпания доступной оперативной памяти сервера.
maintenance_work_mem, в отличие от work_mem, применяется к обслуживающим операциям — построению индексов, операции VACUUM, восстановлению внешних ключей — и для этих задач можно безопасно выделять заметно больше памяти, поскольку они не выполняются одновременно в таком же массовом количестве, как обычные пользовательские запросы, а более крупный объём памяти для них напрямую ускоряет, например, построение индекса на большой таблице.
effective_cache_size: подсказка планировщику о доступном кэше
effective_cache_size — не фактическое выделение памяти, а информационный параметр, сообщающий планировщику запросов PostgreSQL примерный суммарный объём памяти, доступный под кэширование данных на уровне и shared_buffers, и файлового кэша операционной системы вместе взятых.
effective_cache_size = 12GBПланировщик использует это значение при выборе стратегии выполнения запроса — насколько вероятно, что нужные данные уже находятся в каком-либо из уровней кэша, а не потребуют реального обращения к диску. Заниженное значение effective_cache_size склоняет планировщик к излишне осторожным стратегиям (например, к последовательному сканированию вместо использования индекса там, где индекс на самом деле оказался бы эффективнее), тогда как разумно завышенное в сторону фактического объёма свободной памяти сервера значение обычно приводит к более удачным решениям планировщика.
Практическая рекомендация — устанавливать effective_cache_size в диапазоне 50-75% от общего объёма физической памяти сервера, поскольку это значение отражает не только сам shared_buffers, но и файловый кэш операционной системы, который на сервере, посвящённом преимущественно PostgreSQL, обычно занимает большую часть оставшейся после shared_buffers памяти.
Управление подключениями: max_connections и пулинг
Каждое подключение к PostgreSQL — это отдельный серверный процесс со своими накладными расходами по памяти, и параметр max_connections ограничивает их предельное количество. Интуитивно кажется разумным просто установить очень большое значение на случай пиковых нагрузок, но это ловушка: чрезмерно большое количество одновременно активных подключений создаёт конкуренцию за CPU и память между процессами и на практике часто снижает, а не повышает общую пропускную способность сервера.
max_connections = 200Для приложений с большим количеством коротких подключений (типичная ситуация для веб-приложений с классической моделью "подключение на запрос") заметно эффективнее использовать внешний пул соединений вроде PgBouncer, который держит небольшое количество реальных соединений с PostgreSQL и мультиплексирует через них значительно большее количество клиентских подключений от приложения, избегая накладных расходов на создание и разрушение серверного процесса PostgreSQL под каждый отдельный короткий запрос.
psql -U postgres -c "SELECT count(*) FROM pg_stat_activity;"
psql -U postgres -c "SELECT state, count(*) FROM pg_stat_activity GROUP BY state;"
Большое количество подключений в состоянии idle (простаивающих, не выполняющих запрос прямо сейчас) обычно указывает не на проблему в самой базе данных, а на неэффективную работу пула соединений на стороне приложения — соединения открываются и держатся дольше, чем реально необходимо, и внедрение или донастройка PgBouncer в такой ситуации часто даёт больший эффект, чем дальнейшая настройка самого PostgreSQL.
Autovacuum: обязательный процесс уборки, а не опциональная настройка
PostgreSQL использует многоверсионность (MVCC) — при обновлении или удалении строки старая версия физически не удаляется сразу, а помечается устаревшей и остаётся на диске до тех пор, пока процесс autovacuum не очистит её. Без своевременной работы autovacuum таблицы разрастаются устаревшими версиями строк (bloat), индексы деградируют по эффективности, а в самом крайнем случае возможна проблема с переполнением счётчика транзакций, требующая экстренного вмешательства.
autovacuum = on
autovacuum_vacuum_scale_factor = 0.1
autovacuum_max_workers = 4
autovacuum_vacuum_scale_factor определяет долю изменившихся строк таблицы, при достижении которой запускается автоматическая очистка, — значение по умолчанию 0.2 (20%) разумно для таблиц среднего размера, но для очень крупных таблиц с интенсивной записью может означать слишком редкий запуск очистки в абсолютном количестве строк, и для таких конкретных таблиц стоит понижать этот порог индивидуально.
ALTER TABLE orders SET (autovacuum_vacuum_scale_factor = 0.02);
SELECT relname, n_dead_tup, last_autovacuum FROM pg_stat_user_tables ORDER BY n_dead_tup DESC LIMIT 10;
Запрос к pg_stat_user_tables с сортировкой по n_dead_tup (количеству накопленных устаревших версий строк) — быстрый способ найти таблицы, для которых текущая настройка autovacuum не успевает за темпом изменений данных, прежде чем это проявится в виде заметной деградации производительности запросов к этим таблицам.
EXPLAIN ANALYZE: как читать план выполнения запроса
EXPLAIN ANALYZE показывает не только теоретический план, который планировщик собирается использовать для выполнения запроса, но и фактические измеренные показатели после реального выполнения — количество строк на каждом шаге, затраченное время, и это делает его основным инструментом диагностики медленных запросов.
EXPLAIN ANALYZE
SELECT * FROM orders WHERE customer_email = 'user@example.ru';
Узел Seq Scan в выводе означает последовательное сканирование всей таблицы целиком — для таблицы с большим количеством строк и селективным условием фильтрации (то есть отсеивающим значительную долю строк) это почти всегда признак отсутствия подходящего индекса, поскольку планировщику приходится прочитать каждую строку таблицы, чтобы определить, подходит ли она под условие запроса. Узел Index Scan или Bitmap Index Scan, напротив, означает, что планировщик нашёл и использовал подходящий индекс для быстрого нахождения нужных строк без полного сканирования таблицы.
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM orders WHERE customer_email = 'user@example.ru';
Флаг BUFFERS добавляет информацию о том, сколько данных было прочитано из кэша (shared hit) и сколько потребовало реального обращения к диску (read) — большое количество реальных чтений с диска для запроса, который выполняется часто, обычно указывает либо на нехватку памяти под shared_buffers, либо на то, что рабочий набор данных этого запроса просто больше доступного объёма кэша.
Когда добавлять индекс, а когда не стоит
Индекс имеет смысл добавлять для столбцов, регулярно участвующих в условиях WHERE, JOIN или ORDER BY запросов, реально выполняемых приложением, особенно когда эти столбцы селективны — то есть отсеивают значительную часть строк таблицы, а не почти все строки подряд (индекс по полю с двумя-тремя возможными значениями на таблице из миллионов строк редко даёт практическую пользу).
CREATE INDEX CONCURRENTLY idx_orders_customer_email ON orders (customer_email);Ключевое слово CONCURRENTLY заставляет PostgreSQL строить индекс, не блокируя таблицу для операций записи на всё время построения, — построение занимает дольше по времени, чем обычное создание индекса, но не останавливает работу приложения с этой таблицей, что критично для построения индексов на продакшн-таблицах без выделенного окна обслуживания.
Обратная сторона каждого индекса — дополнительные накладные расходы на любую операцию изменения данных: при вставке, обновлении или удалении строки PostgreSQL должен поддерживать актуальность не только самой таблицы, но и всех существующих индексов, ссылающихся на изменённые столбцы. На таблицах с очень интенсивной записью и множеством редко используемых индексов эти накладные расходы способны заметно замедлить именно операции записи, поэтому периодическая ревизия неиспользуемых индексов через pg_stat_user_indexes и удаление тех, что фактически не задействуются планировщиком, — разумная практика для зрелой базы данных.
pg_stat_statements: поиск самых затратных запросов
pg_stat_statements — расширение, накапливающее статистику по всем выполняемым на сервере запросам: суммарное и среднее время выполнения, количество вызовов, объём прочитанных данных — что превращает поиск проблемных запросов из догадок в работу с конкретными числами.
shared_preload_libraries = 'pg_stat_statements'CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
SELECT query, calls, total_exec_time, mean_exec_time
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;Сортировка именно по total_exec_time (суммарному времени), а не только по mean_exec_time (среднему времени одного вызова), важна для правильной приоритизации: запрос, выполняющийся за миллисекунды, но вызываемый миллионы раз в день, может создавать в сумме куда большую нагрузку на сервер, чем редкий, но заметно более медленный по отдельности запрос — и именно первый стоит оптимизировать в первую очередь с точки зрения общей нагрузки на сервер.
WAL и checkpoint: как настройка журнала влияет на запись
Каждое изменение данных в PostgreSQL сначала фиксируется в упреждающем журнале записи (WAL — Write-Ahead Log) и лишь затем отражается в самих файлах данных при контрольной точке (checkpoint). Слишком частые контрольные точки создают избыточную нагрузку на диск, а слишком редкие увеличивают время восстановления после сбоя и объём места, занятого накопленными файлами WAL.
max_wal_size = 4GB
min_wal_size = 1GB
checkpoint_completion_target = 0.9
max_wal_size задаёт мягкий верхний предел объёма журнала между контрольными точками — при значении по умолчанию, рассчитанном на минимальные конфигурации, контрольные точки на активно нагруженном сервере запускаются заметно чаще, чем оптимально, создавая всплески дисковой активности. Увеличение этого параметра до нескольких гигабайт для сервера с активной записью снижает частоту контрольных точек за счёт немного большего объёма файлов WAL, накапливаемых между ними.
checkpoint_completion_target растягивает запись изменений во время контрольной точки на большую долю интервала до следующей контрольной точки вместо резкого всплеска записи сразу после её начала — значение 0.9 сглаживает нагрузку на диск равномерно почти на весь промежуток между контрольными точками, что для большинства продакшн-нагрузок заметно приятнее для дисковой подсистемы, чем значение по умолчанию.
Итоги: тюнинг как последовательность, а не разовый набор значений
Настройка PostgreSQL под конкретный сервер разумно начинается с базовых параметров памяти — shared_buffers, work_mem, effective_cache_size, maintenance_work_mem — исходя из объёма доступной оперативной памяти, затем переходит к обеспечению стабильной работы через настройку autovacuum и разумных лимитов подключений, и завершается точечной оптимизацией конкретных медленных запросов, найденных через pg_stat_statements и разобранных через EXPLAIN ANALYZE.
Универсальных "идеальных" значений параметров не существует — приведённые в статье цифры являются разумной отправной точкой для типичного сервера, а не догмой: реальная нагрузка конкретного приложения, соотношение чтения и записи, размер рабочего набора данных всегда вносят коррективы, и финальная настройка должна опираться на измеренные показатели именно вашей базы данных, а не на слепое копирование чужих значений параметров.
Почему стоит выбрать нас
Быстрый запуск
Подберём конфигурацию и развернём проект в день обращения.
Надёжность
NVMe-диски, защита от DDoS и резервные копии по расписанию.
Поддержка 24/7
Дежурные инженеры на связи в любое время суток.
Настройка под ключ
Установим CMS, настроим веб-сервер, SSL и почту за вас.
Перенос без простоя
Аккуратно перенесём сайт и базу данных на новый сервер.
Прозрачные цены
Актуальные тарифы и честный подбор без навязывания.
Вопросы и ответы
Какой процент RAM сервера стоит выделять под shared_buffers?
Стандартная отправная точка — около 25% физической памяти сервера, выделенного под PostgreSQL, а не 80% и выше, как иногда интуитивно ожидают: PostgreSQL активно полагается на файловый кэш операционной системы в дополнение к собственному shared_buffers, и чрезмерно большое значение оставляет операционной системе слишком мало памяти для этого кэша.
Нужно ли перезапускать PostgreSQL после изменения любого параметра в postgresql.conf?
Нет, часть параметров (например, work_mem, большинство параметров autovacuum) применяется через простую перезагрузку конфигурации командой SELECT pg_reload_conf() или сигналом SIGHUP без остановки сервера, тогда как параметры, влияющие на выделение разделяемой памяти при старте (shared_buffers, max_connections), требуют полного перезапуска процесса PostgreSQL.
Что делать, если autovacuum не успевает обрабатывать активно изменяемую таблицу?
Обычно помогает настройка агрессивности autovacuum именно для этой таблицы через ALTER TABLE ... SET (autovacuum_vacuum_scale_factor = ...) — снижение порога срабатывания и уменьшение задержки между итерациями для конкретной горячей таблицы, вместо изменения глобальных настроек для всего кластера баз данных.
Как понять из EXPLAIN ANALYZE, что запросу не хватает индекса?
Главный сигнал — узел Seq Scan (последовательное сканирование всей таблицы) на таблице с большим количеством строк в сочетании с условием фильтрации (Filter), отсеивающим значительную часть просканированных строк, — это означает, что PostgreSQL вынужден прочитать всю таблицу целиком, чтобы найти относительно небольшую часть подходящих под условие строк.
Чем work_mem отличается от shared_buffers?
shared_buffers — это общая для всех подключений разделяемая память, кэширующая данные таблиц и индексов между запросами, тогда как work_mem выделяется отдельно на каждую операцию сортировки или хеш-соединения в рамках одного запроса, и при большом числе одновременных сложных запросов суммарное потребление памяти через work_mem может оказаться заметно выше, чем ожидалось при выборе значения этого параметра.
Нужно ли устанавливать pg_stat_statements отдельно?
Расширение входит в стандартную поставку PostgreSQL, но не включено по умолчанию — требуется добавить его в параметр shared_preload_libraries в postgresql.conf, перезапустить сервер и выполнить CREATE EXTENSION pg_stat_statements в нужной базе данных.
Как быстро проверить, сколько соединений сейчас активно на сервере PostgreSQL?
Через запрос SELECT count(*) FROM pg_stat_activity — он покажет как активно выполняющиеся запросы, так и подключения в состоянии ожидания (idle), и большое количество именно ожидающих соединений часто указывает на проблему в пуле соединений приложения, а не в самой базе данных.
Всегда ли добавление индекса ускоряет работу базы данных?
Нет — каждый дополнительный индекс замедляет операции вставки, обновления и удаления, поскольку СУБД должна поддерживать актуальность не только самих данных, но и всех индексов на затронутой таблице, поэтому индексы стоит добавлять осознанно под конкретные, реально выполняемые в приложении запросы, а не по принципу "индекс лишним не будет".
Как оплачивать услуги?
Оплата помесячная, для облачных серверов доступна почасовая тарификация. Принимаются карты, банковские переводы и электронные кошельки.
Есть ли круглосуточная поддержка?
Да, дежурные инженеры на связи 24/7.
Выдаёте ли закрывающие документы?
Да, предоставим необходимые документы для оплаты.
Как оставить заявку?
Заполните форму на странице или нажмите «Заказать» — мы свяжемся и поможем с подбором.